AIエンジニアリング読書メモ

この記事について
機械学習システムデザインの著者であるChip Huyen氏が、2025年に出版した「AIエンジニアリング」の日本語訳版を読んだので、個人的に勉強になった点の読書メモです。
書籍全体のまとめは、書籍公式のGitHubレポジトリに掲載されています。
https://github.com/chiphuyen/aie-book
1章 基盤モデルを用いたAIアプリケーション開発入門
2020年以降のAIモデルのスケールアップが2つの変化をもたらした
- AIモデルがより多くのタスクを実行できるようになり、幅広いアプリケーション開発が可能になった
- Model as a Service (MAAS)というサービス形態が登場。LLMの開発はデータ、計算リソース、専門人材が必要なため、LLMを提供できる組織は限られる。
言語モデルから大規模言語モデルへ
語彙 : モデルが扱えるトークンのセット。GPT-4の語彙サイズは100256
- モデルが単語を意味のある構成要素に分割できる
- トークン数 < 単語数のため、モデルの語彙サイズを小さくできる
- モデルが未知の単語を処理できるようになる
言語モデルは2つのタイプがある
- マスク言語モデル : シーケンス内の任意の場所にある欠落しているトークンを、そのトークンの前後両方の文脈を使って予測するよう学習. BERTが有名な例.
- 自己回帰モデル : シーケンスにおいてそれ以前のトークンのみを用いて、次のトークンを予測するよう学習. テキスト生成を行う場合の選択肢になる。
言語モデルは補完マシンと考えれる。テキスト(プロンプト)が与えられると、テキストを補完しようとする。例) プロンプト : “生きるべきか死ぬべきか” → 補完 : “、それが問題だ。”
補完は確率に基づく予測であり、正しさが保証されないという、確率的な性質を言語モデルは持つ。
数ある機械学習アルゴリズムの1つにすぎない言語モデルが、スケーリング手法で中心的な役割を果たすことになった理由は、言語モデルが自己教師あり学習で訓練できるのに対して、他の多くのモデルは教師あり学習を必要とすること。
自己教師あり学習は、明示的なラベルを必要とせず、モデルが入力データ自身(テキストシーケンス)からラベルを推論できる。
2025年時点では1000億パラメータを持つモデルが大規模と考えられる。
大規模なモデルほど、多くのデータを必要とする。モデルの規模が多くなるほど、その性能を最大限に引き出すためにより多くの訓練データが必要になるため。
大規模言語モデルから基盤モデルへ
基盤モデル(マルチモーダルモデル): より多くのデータモダリティ(データの種類や形式)を取り込めるように、言語モデルを拡張したモデル. テキストトークンと他のモダリティのトークンから、次のトークンを生成.
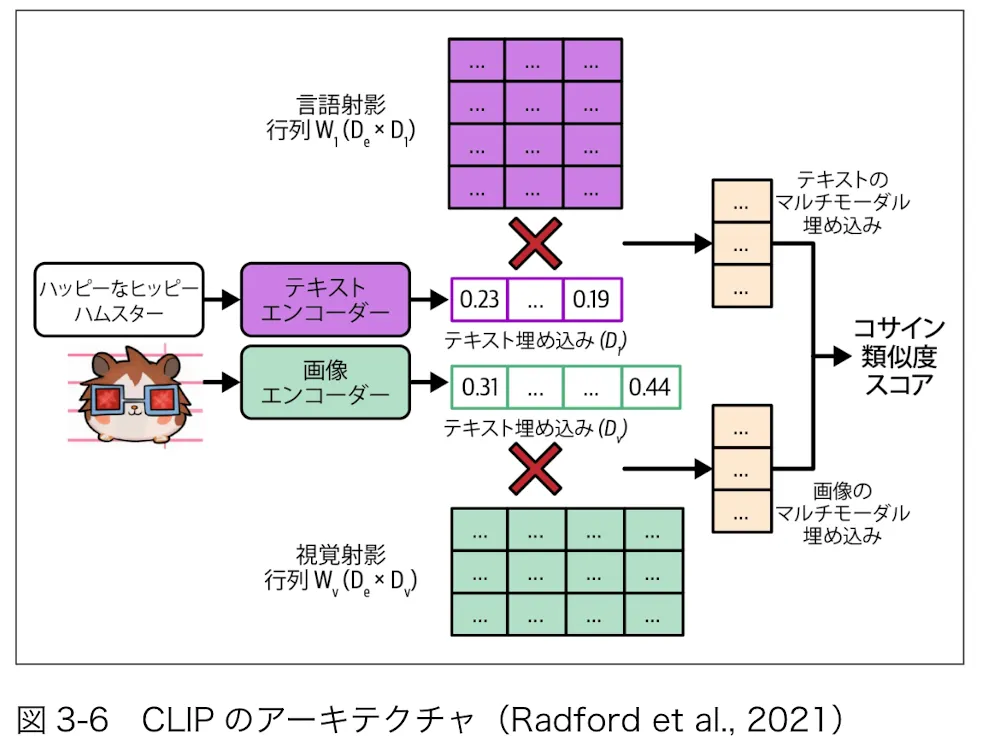
OpenAIは自然言語教師あり学習でCLIPを訓練。インターネット上で同時に出現する (画像、テキスト)ペアを見つけ出した。CLIPは埋め込みモデルで、テキストと画像の両方に対応する埋め込み(ベクトル表現)を生成するように学習されている。CLIPのようなマルチモーダル埋め込みモデルは、LLaVA、Geminiのような生成系マルチモーダルモデルの基盤技術となっている。
基盤モデルは、その規模と大きさと学習方法のおかげで幅広いタスクに対応できる。
基盤モデルからAIエンジニアリングへ
AIエンジニアリングとは、基盤モデルをベースにアプリケーションを構築するプロセスのこと
AIエンジニアリングが成長してる3の要因
- 汎用的なAI能力 : 基盤モデルが強力なのは、より多くのタスクを実行できること。以前は不可能と考えられていたアプリケーションが実現可能となった。
- AIへの投資の増加 : AIアプリケーションの開発コストが低下し、市場投入までの時間が短縮されたことでAIへの投資収益率(ROI)が魅力的になっている。
- AIアプリケーション構築の参入障壁の低下 : モデルプロバイダーによって広められた、Model as a Serviceというアプローチが、AIを活用したアプリケーション開発を容易にした。
基盤モデルの開発は、大企業、政府、野心的で資金力のあるスタートアップに限られる。
2022年9月のインタビューで、Sam Altmanは大多数の人々にとって最大の機会は、基盤モデル開発競争への参加ではなく、基盤モデルを特定のアプリケーションに応用することだと述べている。
基盤モデルのユースケース
AIサービスの紹介サイト
https://theresanaiforthat.com/
本書における生成AIのユースケースまとめ
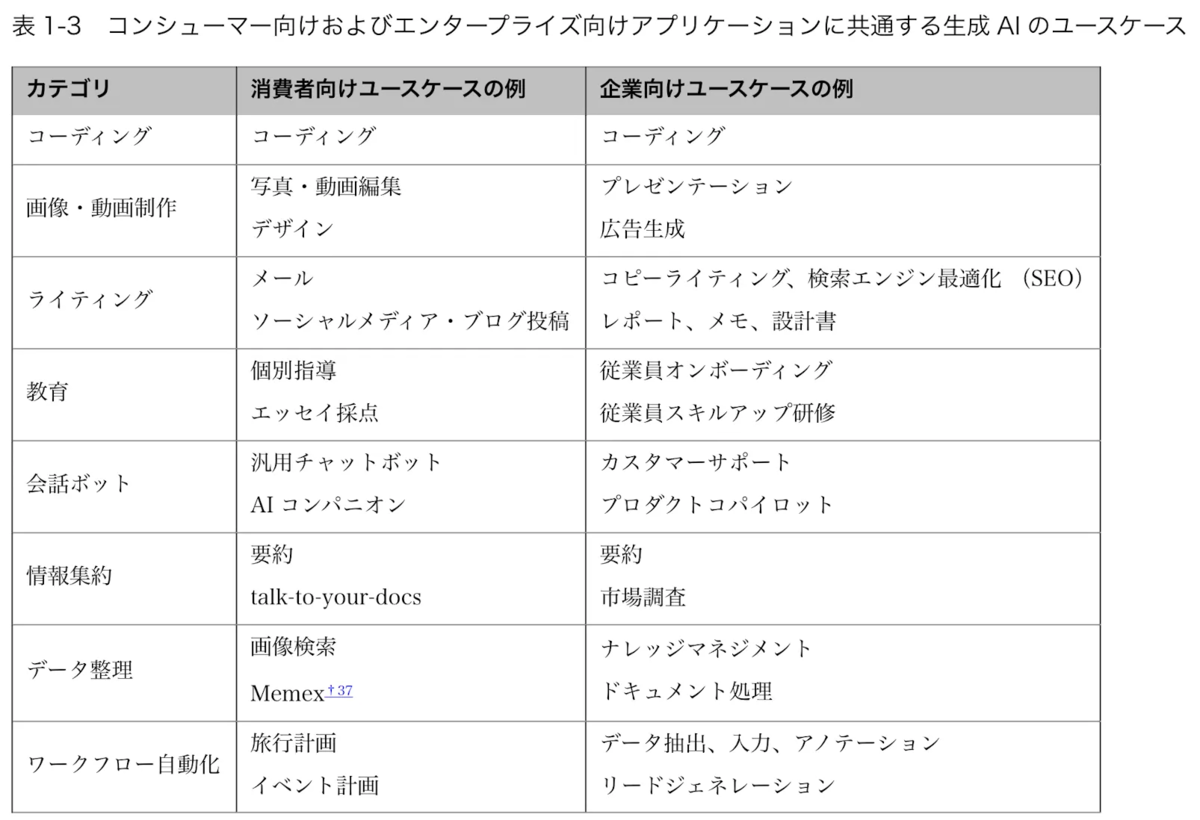
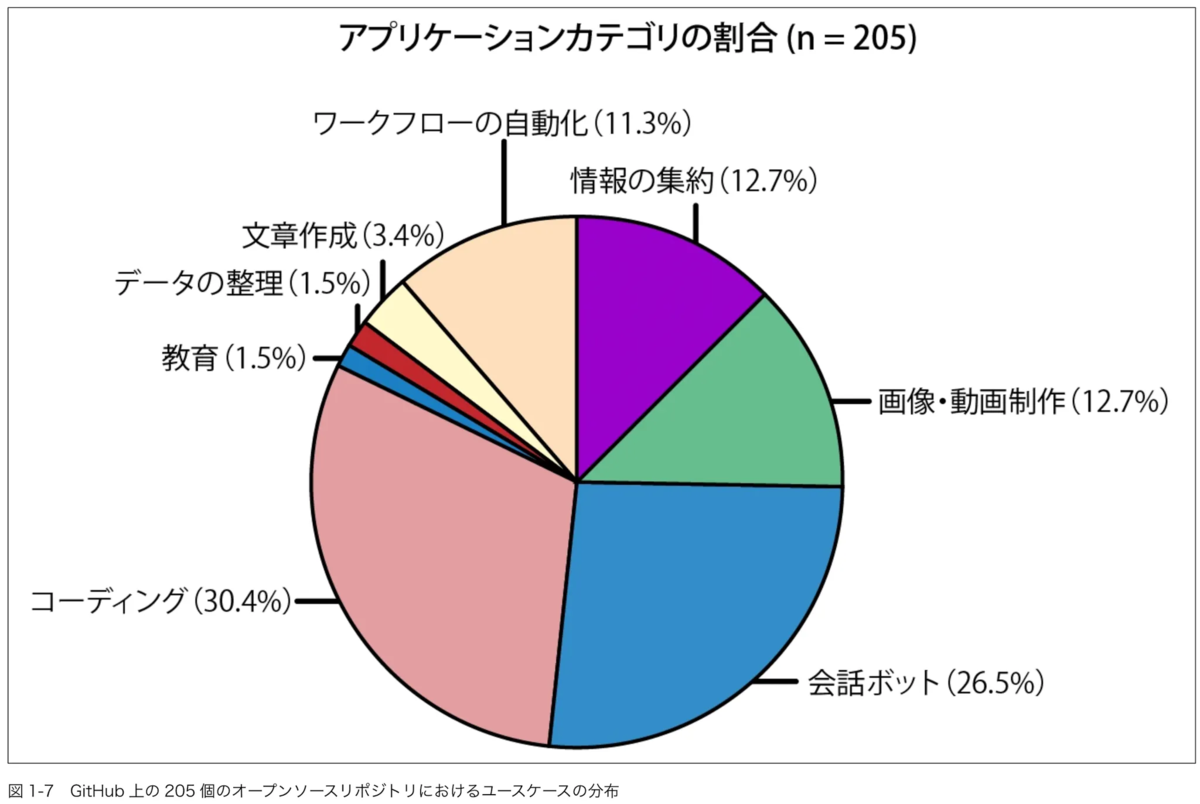
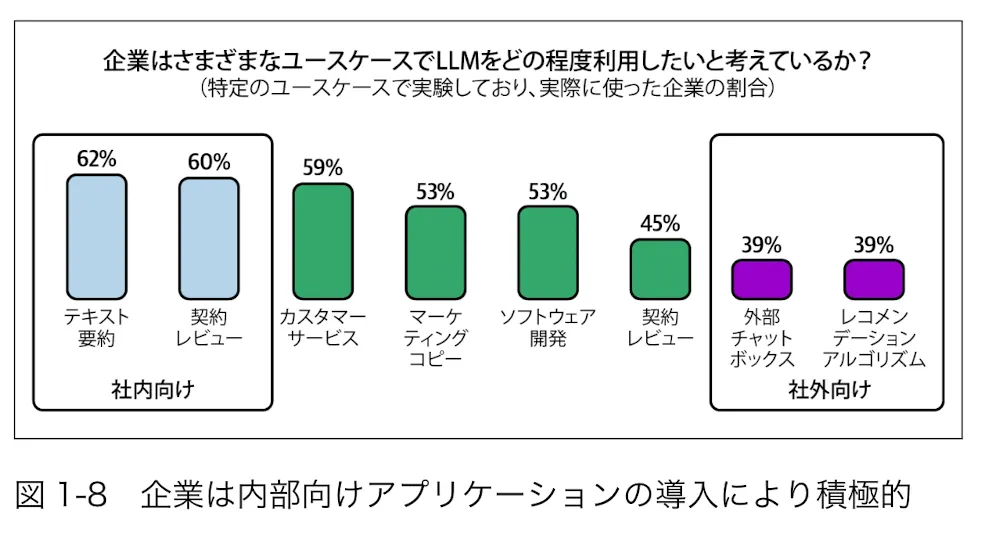
エンプラではリスクの低いアプリケーションが好まれる。2024年のa16z Growthレポートでは、企業は外部向けアプリケーションよりも、内部向けアプリケーションの導入を早く進める傾向が見られる。https://a16z.com/generative-ai-enterprise-2024/
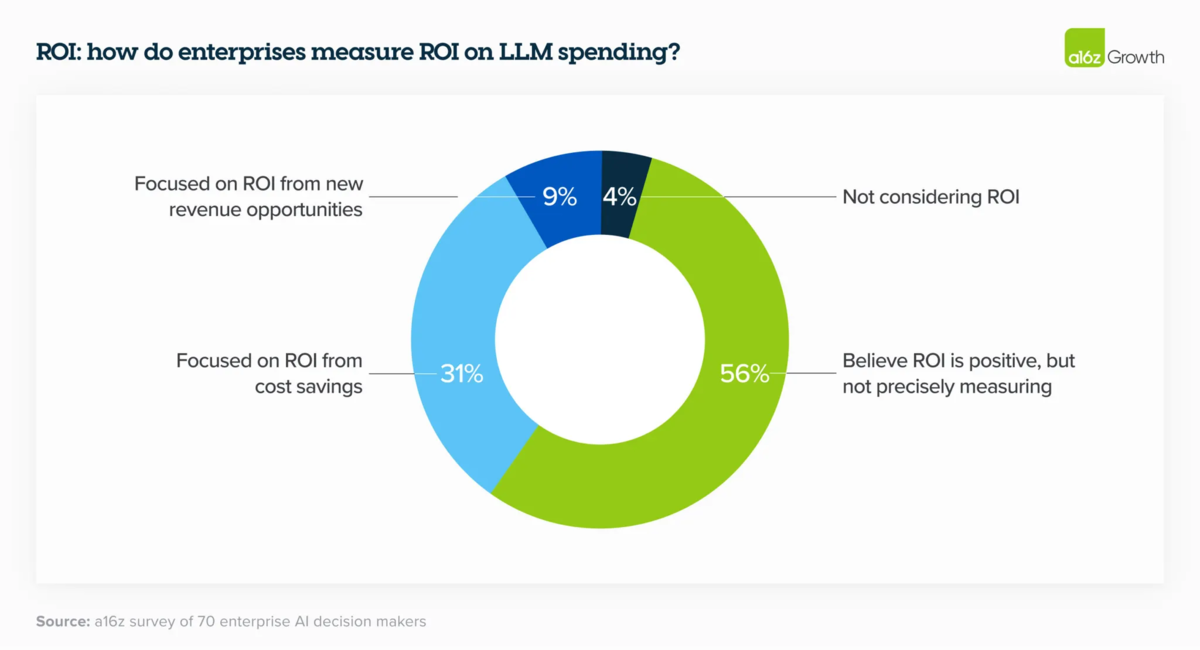
AI投資へのROIの測定が曖昧になっている。コスト削減のROIに着目してる企業が多い。
基盤モデルはオープンエンド(出力が限定されない)が、アプリケーションの多くはクローズドエンド(出力が限定される)なタスクを対象としている。
生成AIのユースケースでコーディングが人気なのは
- AIがコーディングを得意としてる
- AIエンジニア自身がコーダーで、コーディングの課題に触れる機会が多かった
画像動画生成
生成AIの確率的な性質から、クリエイティブなタスクに適してる。
広告・マーケティング分野でAIの導入が進んでいる。企業のマーケティング費用は大きいため、AIによる自動化は大幅なコスト削減が見込める可能性がある分野。
文章作成
人間が頻繁に行う作業で、時には非常に単調で、多少の間違いも許容されるためAIの活用に適してる。
SEOに最適化されたテキストが大量に含まれるインターネット上のデータで訓練されているため、AIはSEOに強い特長がある。結果、粗悪なコンテンツファームの登場を後押ししてる。低品質なウェブサイトが、AIで生成したコンテンツを大量に掲載し、広告枠を販売してる。
教育
生徒がより早く学ぶことを支援するのにAIを活用できる。
Chip氏は、広告がパーソナライズされるのに、教育がそうなっていないことを奇妙に感じてる。
個別チューターとしてAIを活用し、学習者がスキルを習得するのを支援できる。
会話ボット
企業向けではカスタマーサポートボットが人気。面倒でわかりにくいタスクを顧客がこなすのを支援するプロダクトコパイロットの役割も果たせる。
スマートNPC(限られたセリフと行動しか行えない従来のNPCをAIで賢くしたもの)の可能性。
情報の集約
AIは情報を集約し、要約する能力がある。
Talk To Your Docs : 会話形式でユーザーが情報を引き出すアプリケーション
効率的な情報の集約と共有は、中間管理職の負担を減らし、組織のスリム化に貢献する。
データの整理
AIは画像や動画に関するテキスト説明を生成したり、テキストクエリに一致する画像を検索するのに役立つ。
AIはデータの可視化・外れ値の特定・予測を行うことができる。
企業はAIで非構造化データから構造化データを抽出し、データの整理や検索に役立てることができる。
ワークフローの自動化
最終的に、AIが可能な限り多くの作業を自動化することが理想。
エンドユーザー向けには、レストラン予約、払い戻しの申請、旅行計画、フォーム入力など日常タスクの自動化。
企業向けには、リード管理、請求書発行、経費精算、顧客からの問い合わせ対応、データ入力など反復的なタスクを自動化。
エージェント: 計画を立ててツールを利用できるAI
Chip氏は、AIエージェントは一人一人の生産性を大幅に向上させ、非常に大きな経済的価値を生み出す可能性を秘めていると考えている。
AIアプリケーションの計画
企業のAIアプリケーション開発で対応しようと考えているリスク(リスクが高い順)
実行しなければ、AIを活用する競合他社に取って代わられ、時代遅れになってしまう可能性
AIが自社ビジネスの存亡に関わる大きな脅威となる場合、AIの導入は最優先事項としなければならない
実行しなければ、収益向上や生産性改善の機会を逃す
ほとんどの企業は、AIがもたらす機会を捉えるためにAIを導入してる
AIが自社のビジネスにどう適合するかわからないものの、時流に乗り遅れたくないと考えている場合
資金的な余裕があるなら、新しい革命的技術が自社ビジネスに与える影響を理解するためのリソースを投じるのは悪い考えではない
AppleのプロダクトにおけるAI活用方法
http://developer.apple.com/design/human-interface-guidelines/machine-learning
human-in-the-loop : AIの意思決定プロセスに人間が関与する仕組み
AIアプリケーションをスタンドアロン製品として販売する場合、防御可能性(競合優位性)を考慮することが重要。
AI活用の参入障壁の低さは利点であると同時に、課題でもある。
基盤モデルの上にアプリケーションを構築することは、モデルの上に独自のレイヤーを追加するのと同じ。基盤モデルの機能が拡張されると、自分たちが提供してるレイヤがモデル本体に取り込まれて、アプリケーションが陳腐化するリスクを持つ。
生成AI黎明期によく聞かれたジョーク「AIスタートアップはOpenAIやClaudeのラッパーに過ぎない」
Chip氏の大手ベンチャーキャピタルのパートナーは、多くのスタートアップの製品が「所詮、Google DocsやMicrosoft Officeの一機能に過ぎない」レベルだと指摘
AIにおける競合優位性は、テクノロジー、データ、ディストリビューション(製品をユーザーに届ける能力)の3つ。
多くのスタートアップは、大企業が見過ごしたニッチな機能から事業を始め、最終的にその競合を凌駕するまでに成長。
AIプロダクトを計画する際はラストマイル問題を考慮する必要がある。
基盤モデルは基本的な能力が高いため、機能してるように見えるデモを作るのは簡単。デモから製品として完成させるのに、数ヶ月、数年かかることがある。
AIプロダクトの保守は、AIの変化の速さが課題になる。
一方、コンテキスト長が長くなり、モデルの出力品質は向上し、推論のレイテンシ、コストは下がっているポジティブな変化もある。
AIの規制に関する変化への適応は難しい課題。
知的財産(IP)とAIの利用に関する規約はまだ整備の途上にあるため、IPを重視する企業は将来的に自社のIPを失うリスクを懸念してAIの利用に慎重になっている。
AIエンジニアリングスタック
FOMO(Fear of Missing Out) : 取り残されることへの恐れ
AIエンジニアリングの急速な成長は注目を集め、FOMOも生み出した。
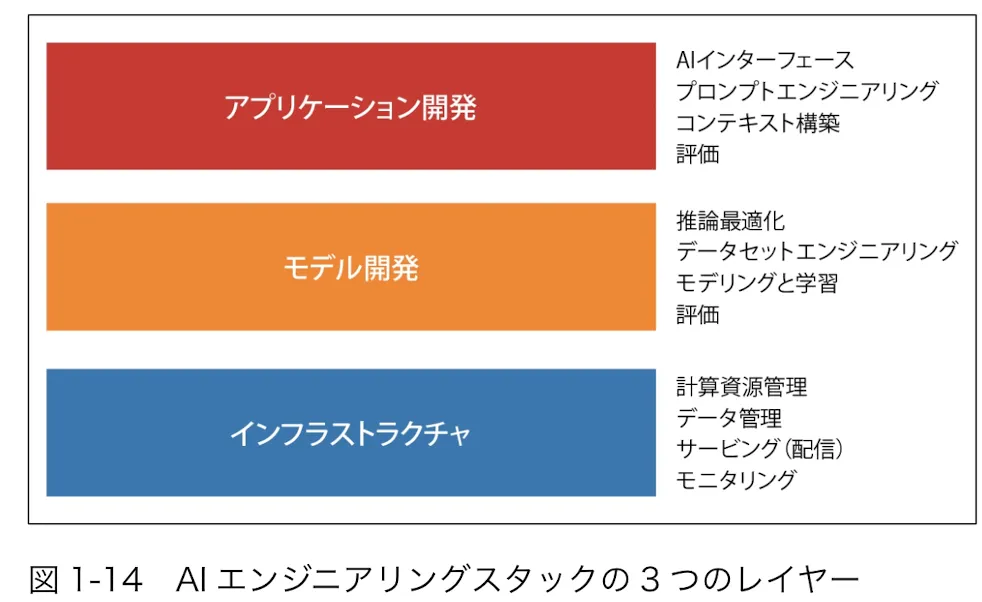
基盤モデルを用いたアプリケーション構築は、従来のMLエンジニアリングと主に3つの点で異なる
- MLエンジニアリングでは独自のモデルを訓練する必要があったが、AIエンジニアリングは他の誰かが作成した学習済みモデルを利用する。AIエンジニアリングではモデリングと訓練より、モデル適応に重点が置かれる
- AIエンジニアリングは従来のMLエンジニアリングより大規模なモデルを扱うため、効率的な学習と推論最適化の要求が高い
- AIエンジニアリングはオープンエンドな出力を生成できるモデルを扱うため、評価が困難であり、重要な課題
モデル適応の技術は、モデルの重みを更新する必要があるかに応じて、2つのカテゴリに分類される。
- プロンプトベースの技術 : モデルの重み更新しない
- ファインチューニング : モデルの重み更新する
モデル開発
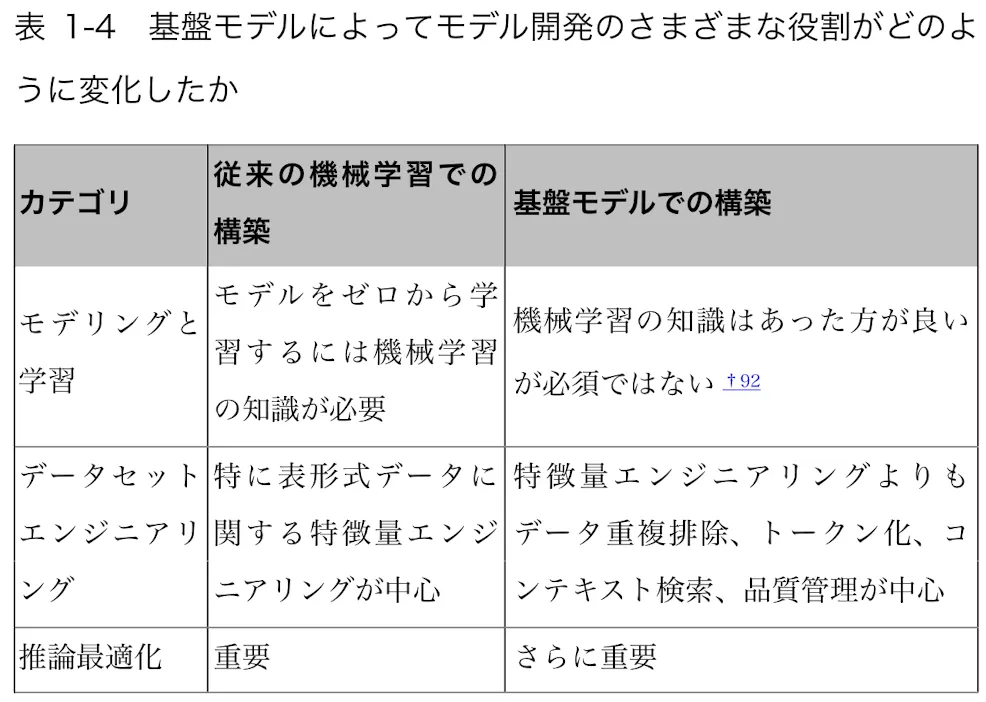
AIアプリケーションの構築には機械学習の知識はもはや必須ではない。
一方で、Chip氏は機械学習の知識は利用できるツールの範囲を広げ、モデルが期待通りに機能しない場合のトラブルシューティングに役立つと述べてる。
事前学習、ファインチューニング、事後学習の区別
- 事前学習: モデルをゼロから学習すること。計算リソースを必要とするため、事前学習は一部の専門家のみが実践可能な技術領域となっている
- ファインチューニング: 学習済みモデルの重みを引き継ぎ、学習をさらに継続させるプロセス
- 事後学習: 事後学習フェーズの後に行われるモデルの学習プロセス。モデル学習者が行う場合は事後学習、アプリケーション開発者が行う場合はファインチューニング。
データセットエンジニアリング: AIモデルの学習と適応に必要なデータをキュレーション、生成、アノテーションを行うこと。
従来のMLエンジニアリングのユースケースはクローズドエンドである一方、基盤モデルはオープンエンド。そのため、データアノテーションがAIエンジニアリングでは大きな課題となる。
MLエンジニアリングでは表形式データを扱うのに対し、基盤モデルは非構造化データを扱う。
モデルがコモディティ化してるので、データが差別化要因となりデータセットエンジニアリングの重要性が高まっていると多くの人が主張してる。
推論最適化 : モデルの推論をより高速かつ低コストにすること
アプリケーション開発
評価: モデルの性能を測るだけでなく、リスクを管理し、新たな可能性を発見すること
基盤モデルが持つオープンエンドな性質と多機能さ、モデルの調整テクニックが無数に存在することが、従来のMLエンジニアリングより評価が難しくなっている。
プロンプトエンジニアリング: モデルの重みを変更することなく、入力だけでAIモデルから望ましい振る舞いを引き出す技術. 特定のタスクを実行するために必要なコンテクストやツールをモデルに与えることも含む。
AIインターフェース: エンドユーザーがAIアプリケーションと対話するためのインターフェースを作成すること。
スタンドアロンのWebアプリ、デスクトップアプリ、モバイルアプリ、ブラウザ拡張機能、チャットボット、プラグイン、アドオン、音声ベース、AR/VRなどのインターフェースがある。
AIエンジニアリング vs フルスタックエンジニアリング
アプリケーション開発へ重点が置かれるようになったことで、AIエンジニアリングはフルスタック開発に近づいている。
AIエンジニアはML分野出身者が多い中、Web開発者やフルスタック開発の経験を持つエンジニアも増えている。
- MLエンジニアリング : データ→モデル→プロダクトの工程
- AIエンジニアリング : プロダクト→データ→モデルの工程
2章 基盤モデルを理解する
学習データ
大規模モデルの学習に十分なデータを収集するのは容易ではない。
そのため、モデル開発者は手元ですぐ手に入るデータに頼らざるを得ないことがよくある。
Common Crawl : インターネット上のウェブサイトをクロールして作成されたデータセット
https://commoncrawl.org/
Chip氏は学習データを公開していないモデルでも、Common Crawlが使用されているのではないかと疑っている。
少量の高品質データで学習されたモデルが、大量の低品質データで学習されたモデルを上回る性能を示すことがある。
Common Crawlの言語には偏りがある。英語がデータセットの大部分を占める。
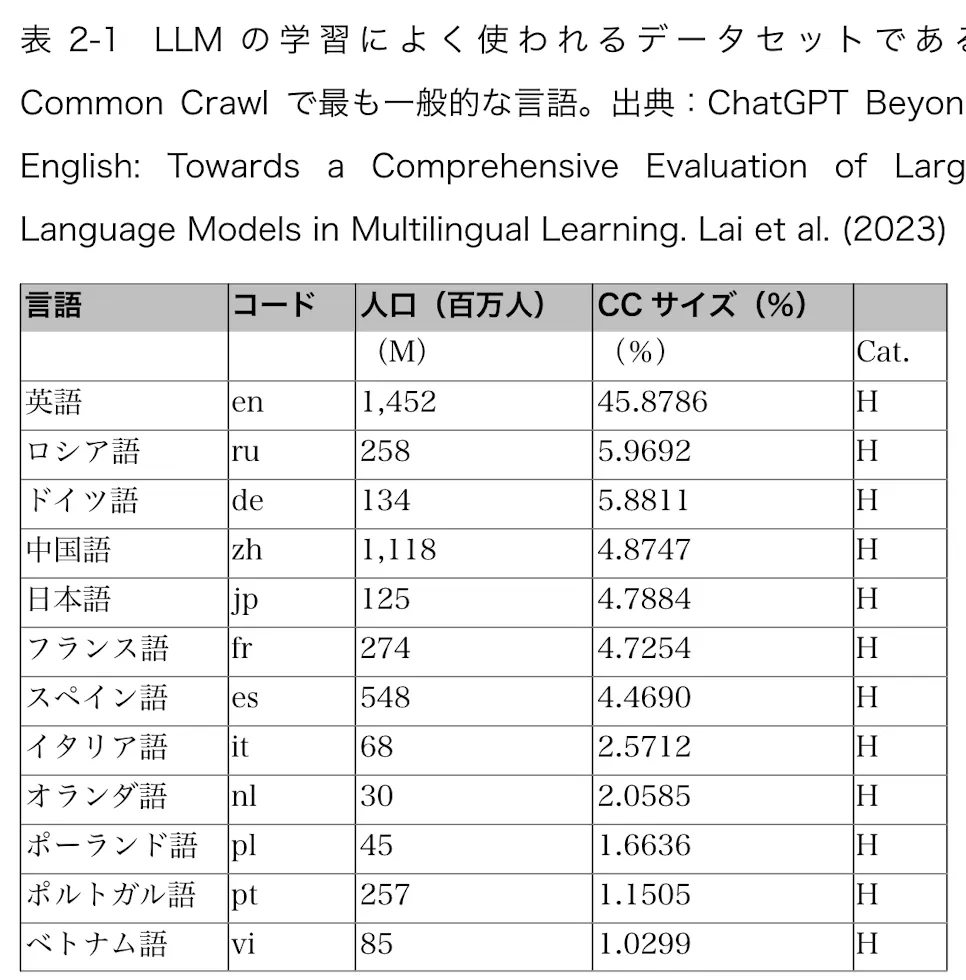
モデルは英語以外の言語で予期せぬ性能上の課題を抱えることがある。例えば、英語よりも中国語の方が偽情報を生成しやすいという報告がある。
https://www.newsguardtech.com/special-reports/chatgpt-generates-disinformation-chinese-vs-english/
モデルの推論レイテンシとコストは、入力と応答のトークン数に比例するため、トークン化の効率が悪い言語は推論レイテンシとコストが高くなる可能性がある。
多くのモデルが英語以外の言語に焦点を当てて学習されてきている。
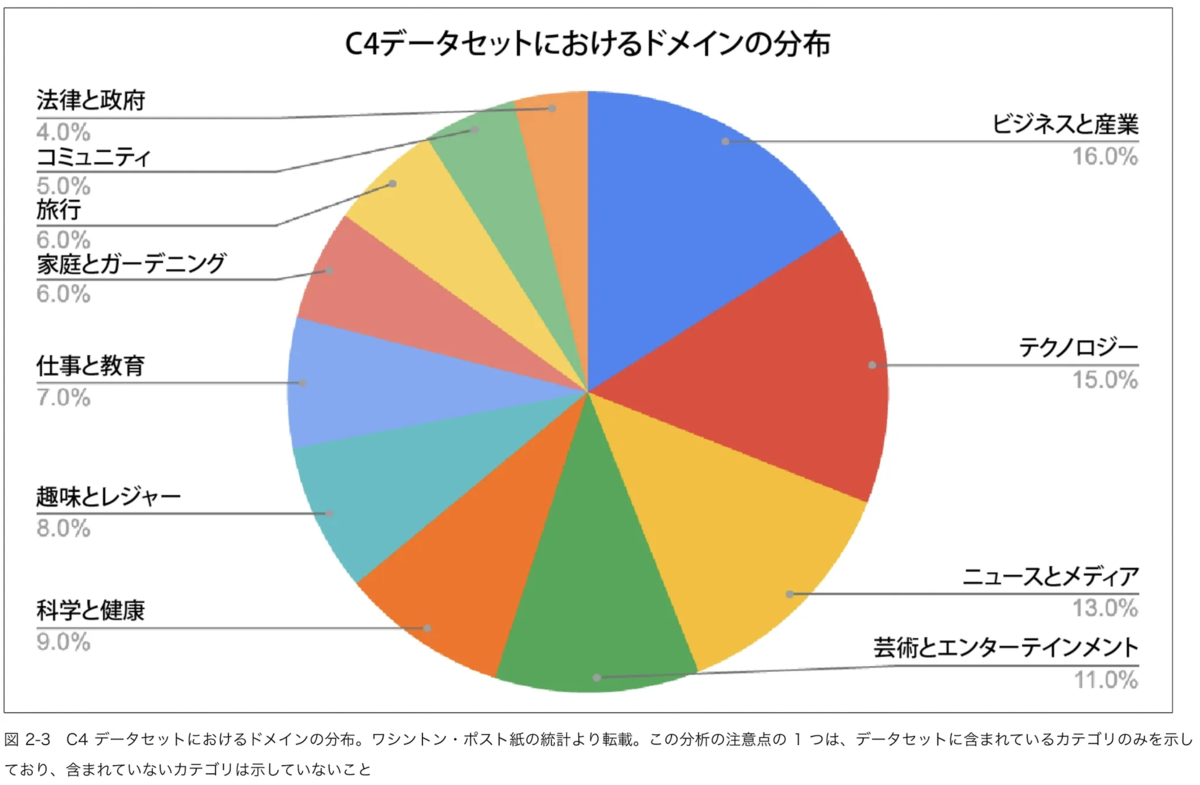
基盤モデルはさまざまなドメインのタスクに関する質問に答えられるが、学習中に見たことないドメイン固有のタスクではうまく機能しない可能性がある。
モデリング
2025年時点では基盤モデルの主流なアーキテクチャは、Transformer アーキテクチャ。
seq2seqの課題
- 入力の最終的な隠れ状態のみを使用して出力トークンを生成するため、出力の品質が制限される
- RNNのエンコーダーとデコーダーが、入力処理と出力生成の両方が逐次実行されるため、長いシーケンスでは処理が遅くなる
Transformerアーキテクチャはアテンション機構によって上記の問題を解決。
Transformerベースの言語モデルの推論は2つのステップで構成
アテンション機構は3つのベクトルを内部で使用
クエリベクトルとキーベクトルの内積を計算することで、入力トークンにどれだけ注意を払うか計算する。
シーケンスが長くなるほど、より多くのキーとバリューのベクトルを計算して保持する必要があり、Transformerモデルのコンテキスト長を拡張するのを難しくする。
Transformerブロック前の埋め込みモジュール: トークンの埋め込み行列 + トークンの位置埋め込み行列。モデルの最大コンテキスト長は位置情報の数で決まる。
コンテキスト長の増加はモデルが必要とするメモリ量に影響するが、モデルのパラメータ数には影響しない。
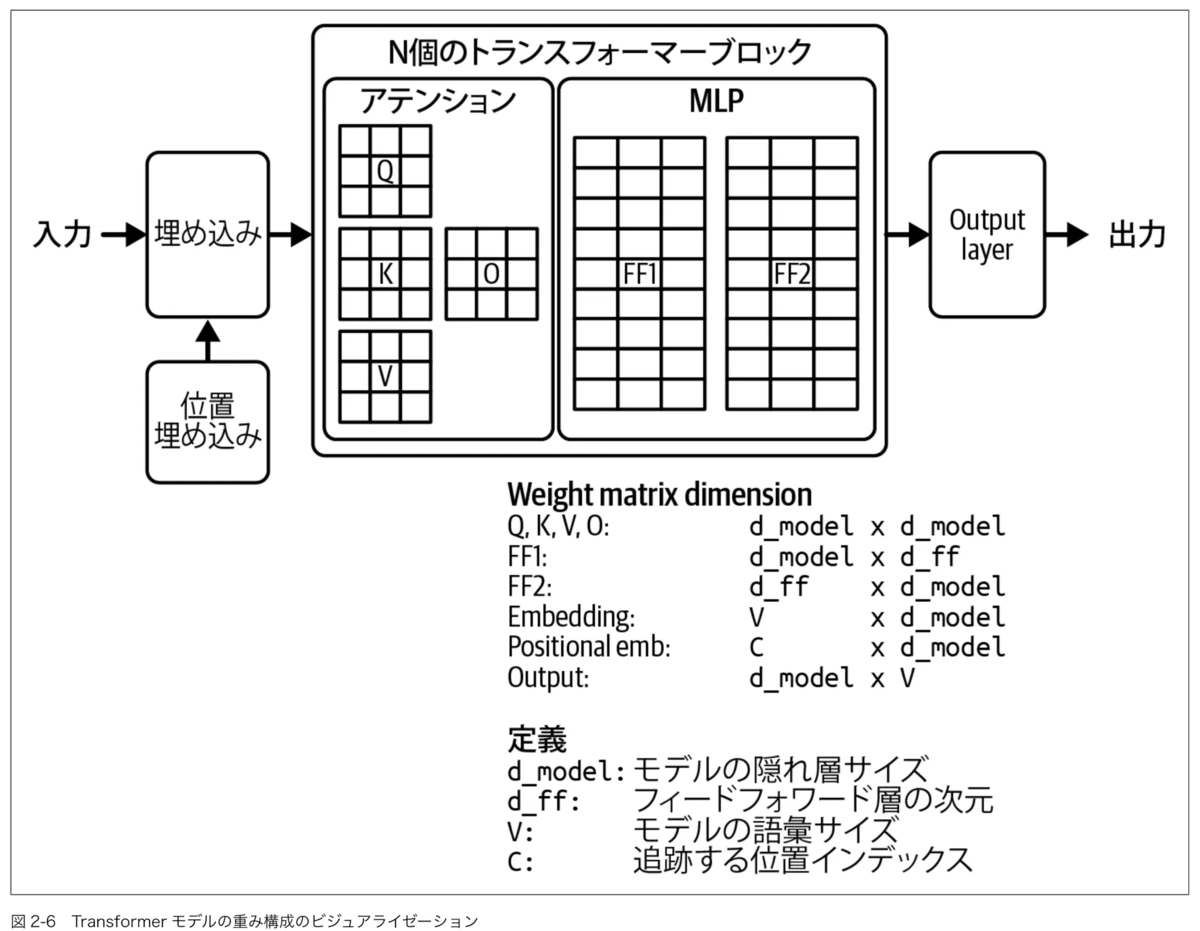
流行ったモデルアーキテクチャ
- Seq2seq : 2014 ~ 2018
- GAN : 2014 ~ 2019
- Transformer : 2017 ~
LLMの開発では、長いシーケンスのモデリングは依然として中心的な課題。
Transformerに変わる新しいアーキテクチャに関する技術として、S4, H3, Mamba, Jambaが挙げられている。
モデルパラメータ数から必要な計算資源を見積もれる。
例) 1パラメータが2バイトの70億パラメータのモデルの実行には、少なくとも140億バイト(14GB)必要。
Mixture of Experts (MoE) : パラメータのグループがいくつかあり、各グループがエキスパートとなるモデル。一部のパラメータが共有されるためパラメータ数を抑えられる。
言語モデルの学習データセットサイズはトークン数で測定する。ただし、トークン化の方法で同じデータセットでもトークン数は変化する。
Llama 1 : 1.4兆トークン、Llama 2 : 2兆トークン、Llama 3 : 15兆トークン
2025年時点では大規模言語モデルは、データのエポック1回分のみで事前学習される。
FLOP(浮動小数点演算) : 特定のタスクに対して実行される浮動小数点演算の総数を表す指標
注意) FLOPsはタスクの計算要件を測定、FLOP/sはマシンのピーク性能
NVIDIA H100は 1日あたり5.2 * 1018 FLOPs
GPT-3 175Bは3.14 * 1023 FLOPSが必要
H100が256基ある場合に学習にかかる時間は、 (3.14 * 1023 ) / (256 * 5.2 * 1018) = 236日と計算できる。
実際には、常にピーク性能を使用できず、使用率50%が得られれば問題ないとされる。
使用率 70%, H100 1基あたり2ドル/時の場合、GPT-3 175Bの学習には400万ドル以上かかると見積もれる。
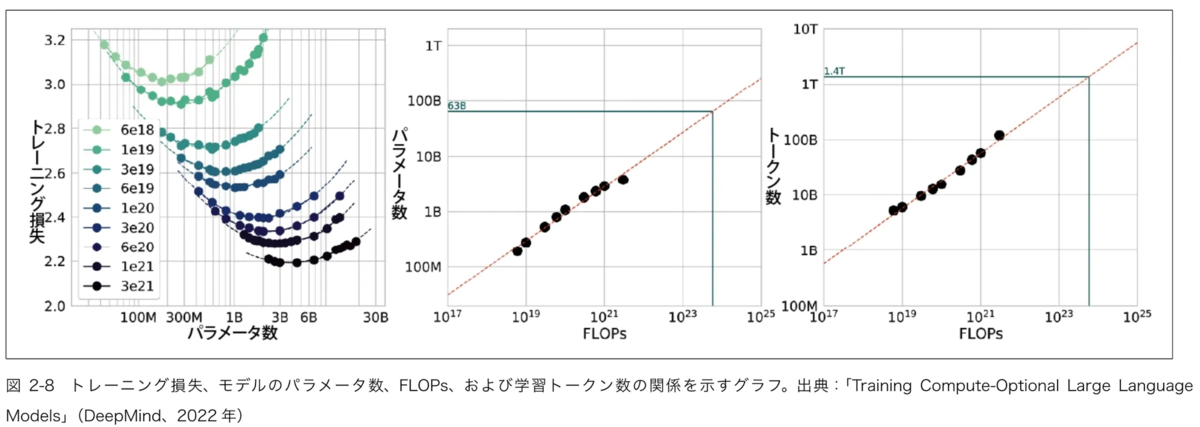
モデルの規模を表す指標
- パラメータ数 : モデルの学習能力の代理指標
- モデルが学習したトークン数 : モデルがどれだけ学習したかの代理指標
- FLOPs数 : 学習コストの代理指標
Chinchilla論文 : https://arxiv.org/abs/2203.15556
Chinchillaのスケール則 : モデルサイズと学習トークン数は等しくスケールされるべき。学習トークンの数がモデルサイズの約20倍必要
同じモデル性能であればコストは低下しつつあるが、モデル性能を向上させるためのコストは依然として高い。
Metaの研究では誤差率2%のモデルは、誤差率3%のモデルよりも桁違いに多くのデータ、計算資源を必要とする可能性があると指摘。
https://ai.meta.com/research/publications/beyond-neural-scaling-laws-beating-power-law-scaling-via-data-pruning/
言語モデルでは、クロスエントロピー損失を 3.4natsから2.8natsに低下させるには、10倍の学習データが必要。
しかしながら、小さな性能変化がアプリケーションの品質に大きな違いをもたらす可能性がある。
スケーリングの外挿(ハイパーパラメータ転移) : ターゲットモデルのサイズより小さいモデルに対するハイパーパラメータの影響を研究し、ターゲットモデルのサイズでどのように機能するか推定する。
LLMの学習を行う人はほとんどいないため、ニッチな領域。
スケーリングのボトルネック
- 学習データ: 基盤モデルの学習に使用できるインターネット上のデータが枯渇する
- 電力 : 2030年にはデータセンターは世界の電力の4 ~ 20%を消費すると推定
Chip氏は「インターネット上に何かを公開したことがあるなら、同意の有無にかかわらず、それがすでに何らかの言語モデルの学習データに含まれているか、今後含まれると考えるべき」と述べている。
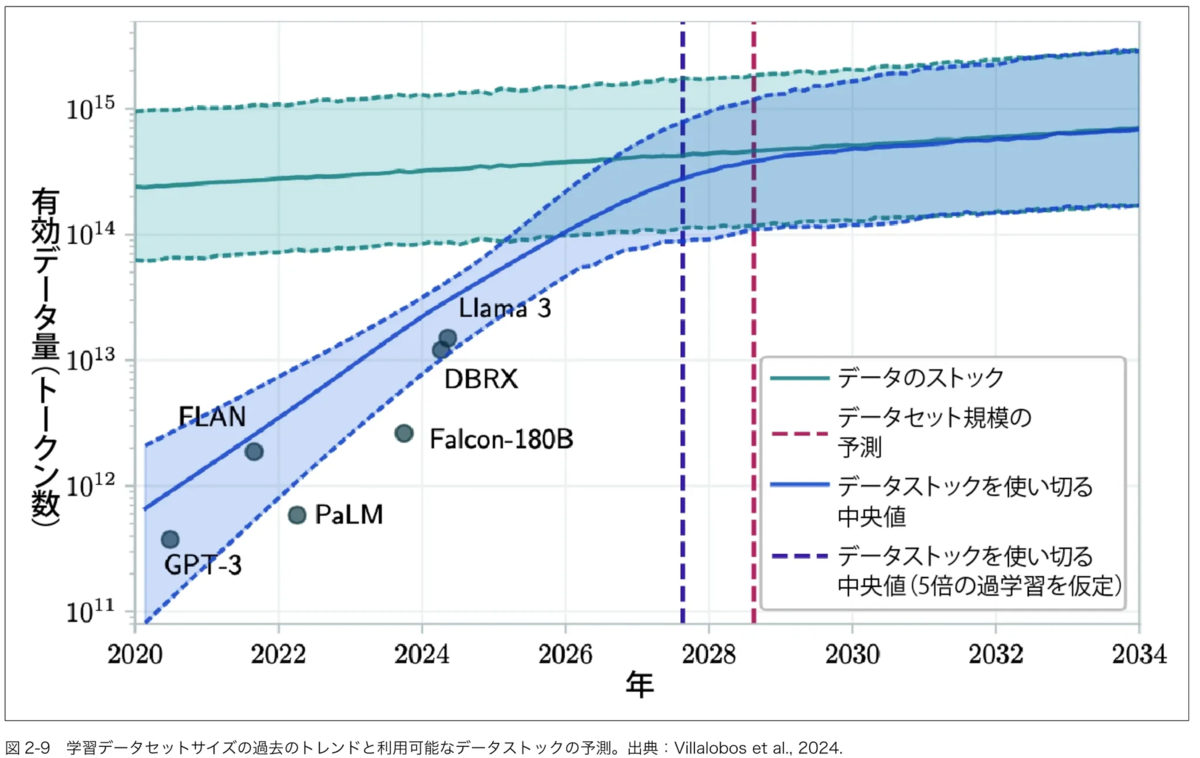
モデルの学習中に学習した特定の情報を忘れさせる方法は、未解決の研究課題。
削除されたコンテンツにモデル経由でアクセスできる可能性がある。
Grokのコア開発者であるIgor Babuschkin氏は「WebはChatGPTの出力で溢れている」と回答してる。
AI生成データで、新しいAIモデルを再帰的に学習することで、元のデータパターンが失われ、時間経過と共に性能が低下する懸念がある。
公開データが枯渇した場合、プロプライエタリデータに頼るのが現実的な道筋。
OpenAIが多くのメディア企業と連携してる理由の一つ。
ChatGPT登場後、RedditやStackOverflowを含むメディア企業が、他社が自社のデータをモデル用にスクレイピングすることを防ぐためにデータ利用規約を変更してる。
事後学習
事前学習済みモデルの課題
- 自己教師あり学習はモデルをテキスト補完のために最適化するもので、会話のためではない
- モデルの出力が人種差別的、性差別的、失礼、不適切なものとなる可能性がある
事後学習は2つのステップで構成
- 教師ありファインチューニング(SFT) : 指示データでファインチューニングし、補完ではなく会話向けにモデルを最適化
- 選好ファインチューニング: 人間の好みにあった応答を出力するようにファインチューニング。強化学習によって行う。
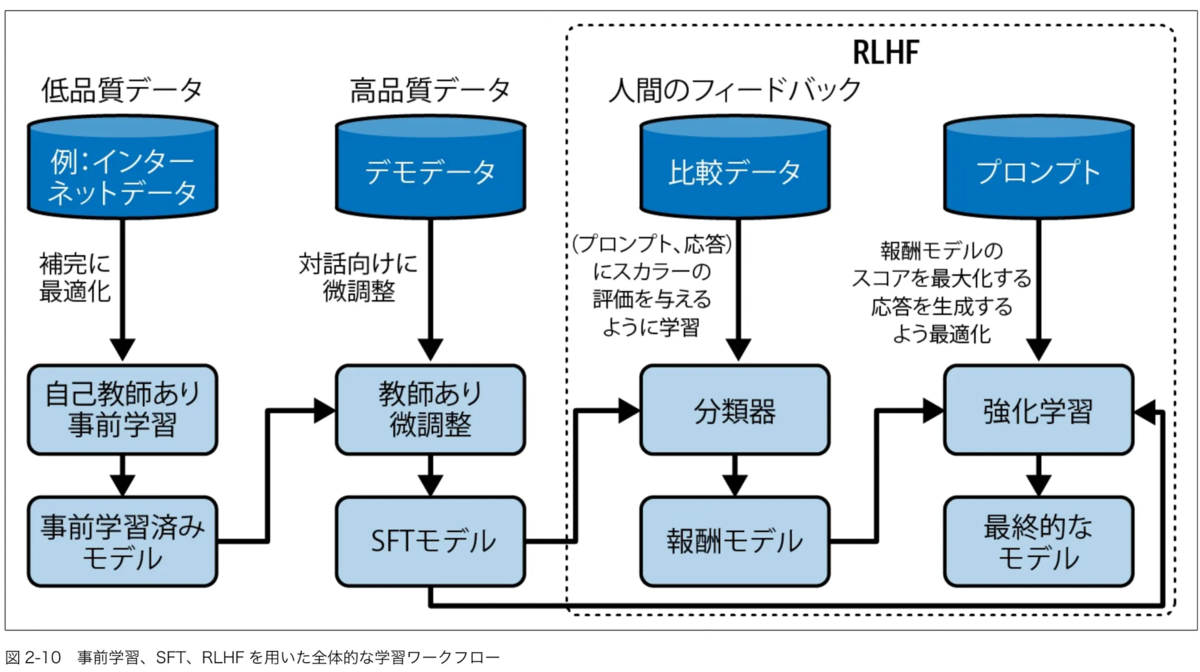
図2-10
プロンプトとレスポンスの組み合わせデータをデモンストレーションデータと呼ぶ。
企業はデモストレーションデータを生成するために、しばしば高度な教育を受けたラベラーを起用する。人間による高品質なアノテーションデータへの依存を減らすために、AIで生成する合成データが注目されている。
技術的にはデモンストレーションデータを最初から学習できるが、自己教師あり学習の事前学習を行う方が優れた結果を出す。
RLHFは2つの部分で構成
- 基盤モデルの出力を評価する報酬モデルを訓練
- 報酬モデルが最大のスコアを与えるような内容を生成するよう、基盤モデルを最適化
Llama3ではDPOという最適化手法が使われている。
https://arxiv.org/abs/2305.18290
報酬モデルはプロンプトとレスポンスの組が与えられた時に、応答の良さを表すスコアを出力する。
比較データ: 2つの応答を比較して、どちらが優れているか判定したデータ
サンプリング
言語モデルの場合、次のトークンを生成するために、モデルは語句内のすべてのトークンに対する確率分布を計算する。
グリーディサンプリング : 常に最も確率が高い結果を選ぶ手法
取りうる値の確率を再分布するために temperatureを使ってサンプリングできる。
高 temperature → モデルの出力はより創造的
低 temperature → モデルが明白な値を選ぶようになる
一部のモデルプロバイダーはモデルによって生成された確率をユーザーに公開してる。OpenAIはlogprobsをサポート(2023年9月まで)。
公開が限定的なのは、logprobsで第三者がモデルを複製しやすくなるため。
top-k : 上位k個のロジットから選択を行うサンプリング手法。アプリケーションの多様性に応じて調整。
top-p : 確率上位のトークン確率を降順で合計し、合計がpに達したときにサンプリング対象を停止する手法。
停止条件
簡単な方法は、固定された数のトークンの後に生成を停止する。
ストップトークンやストップワードを使用する方法もある。
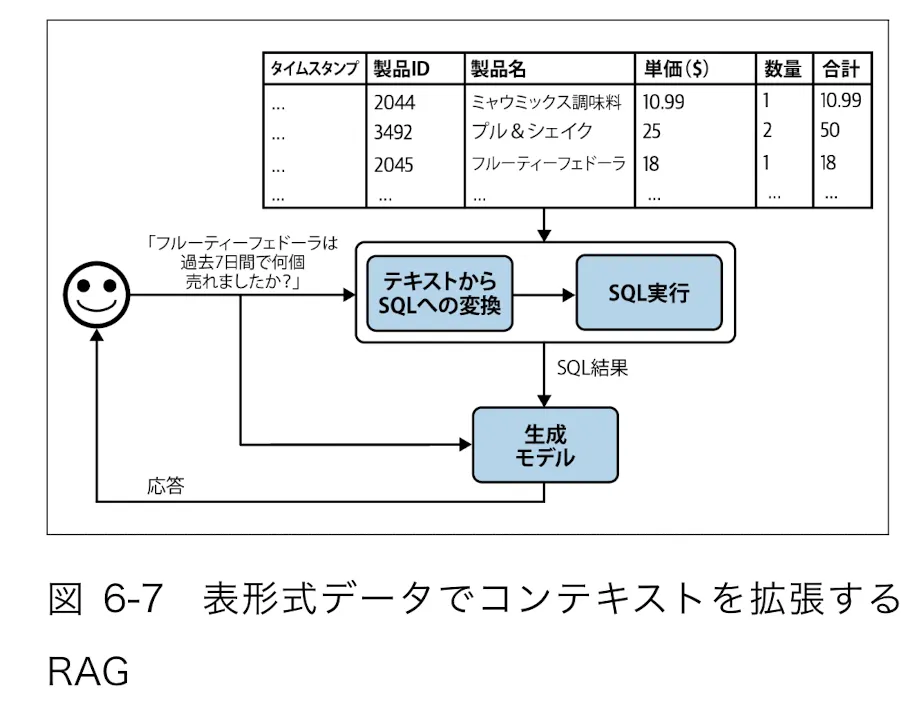
セマンティックパーシング : 自然言語を構造化された機械が読み取り可能な形式に変換すること。例) Text-to-SQL
モデルの構造化出力はプロンプティング、後処理、テスト時計算、制約付きサンプリング、ファインチューニングなどで実現できる。
プロンプティングでモデル任意の形式で出力を生成するように指示する場合、モデルの指示追従能力と指示の明確さに依存する。
後処理では、モデルが犯す共通の間違いを見つけて、自動で修正するスクリプトを実行する。シンプルかつ、低コストな方法。
制約付きサンプリングは、テキスト生成を特定に制約に向けて誘導する手法。
AIエンジニアリングの取り組みの多くは、基盤モデルの確率的な性質をうまく利用しつつも、その悪影響を軽減することを目的としてる.
モデルの非一貫性が発生するシナリオ
- 同じ入力、異なる出力
- わずかに異なる入力、大幅に異なる出力
ハルシネーションが起きる理由として2つの仮説がある
- 言語モデルが与えられたデータと生成したデータを区別できないため
- モデルの内部知識とラベラーの内部知識の不一致があるため
3章 評価方法論
基盤モデルを評価する上での課題
基盤モデルの評価が従来の機械学習モデルの評価と比べて難しい理由
- AIモデルが賢くなるほど、応答内容の正しさを評価できる人間が限られてくる
- 基盤モデルのオープンエンドな性質は、正解データと照合して評価するやり方を困難にする
- モデルプロバイダーが詳細情報を公開していない、アプリケーション開発者側にモデルを理解するための専門知識が不足しているため、多くの基盤モデルはブラックボックスとして扱われている
- 公開されている評価ベンチマークの多くは、基盤モデルの評価には不十分
- 汎用モデルの登場により、評価の対象範囲が拡大してる
フィールズ賞受賞者のTerrence Tao氏は「平凡ではあるものの、無能というわけではない大学院生」と仕事をするようなものと表現した。
https://mathstodon.xyz/@tao/113132502735585408
Chip氏はAIアプリケーション開発者の多くは「結果を目視で確認してるだけ」と答えると述べてる。
モデル評価のための数パターンのお決まりのプロンプト、場当たり的なプロンプト選定が実態として多い。
アプリケーションを継続的に改善していく上では不十分。
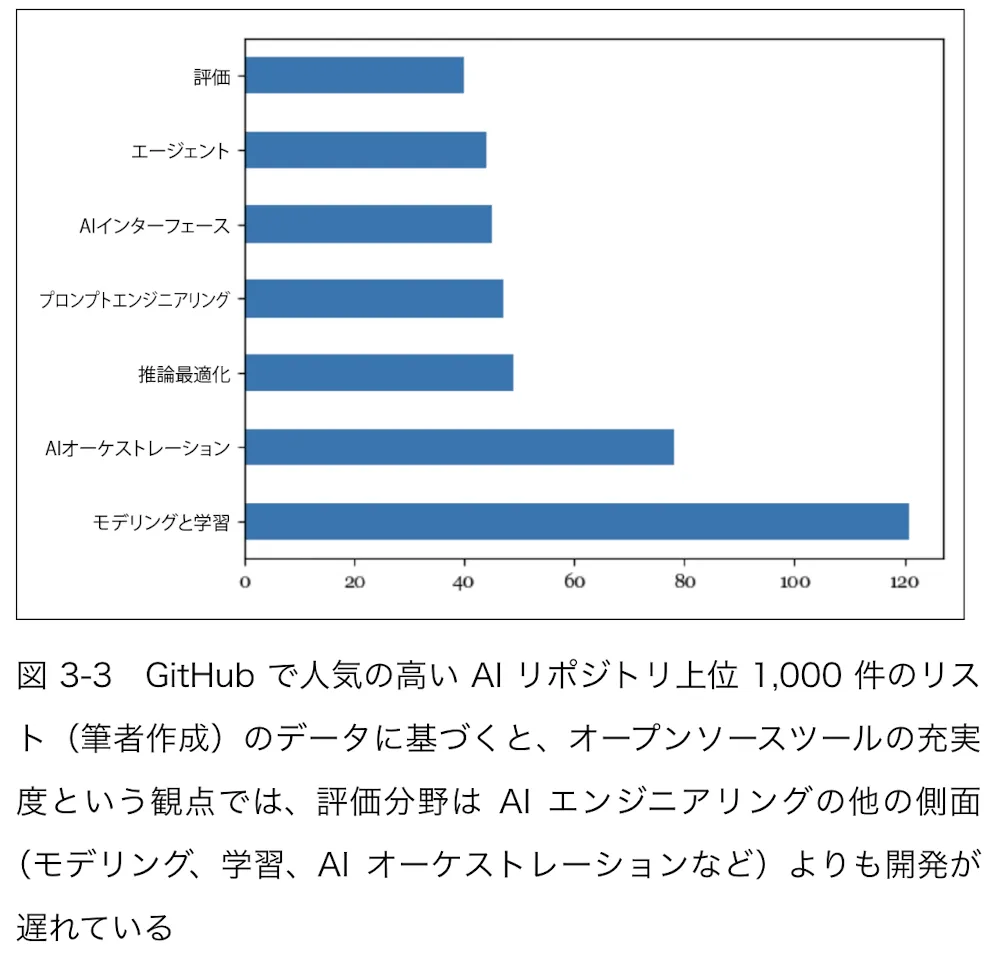
言語モデルの指標を理解する
言語モデルは Claude Shannonの「Prediction and Entropy of Printed English」から広まった。
言語モデル開発の指針となる指標は大きく変わっていない。
エントロピー : トークンが平均してどれだけの情報量を持つかを示す。直感的にはある言語において次に何が現れるかを予測することの難しさを表す指標。単位はBit
クロスエントロピー : あるデータセットにおいて、言語モデルが次に続くトークンを予測する難しさを示す。学習データのエントロピーと、言語モデルが捉えた分布と学習データの分布との乖離で決まる。単位はBit
モデルによってトークン化が異なるため、トークンあたりのビット数をモデル間で比較できない。代わりに、BPS (bits-per-character) を使用する。例)トークンあたりのビット数が6、各トークンが平均2文字で構成される場合、BPC=6/2=3
文字エンコーディング方式の違いによって、各文字のビット数が変わる。
BPCをより標準化した指標としてBPB (bits-per-byte)が使われる。
例)BPCが3で、各文字が7ビット(7/8バイト)の場合、BPB=3/(7/8) = 3.43
言語モデルのBPBが3.43とは、元の各バイト(8ビット)を3.43ビットで表現できる、つまり、元の学習テキストを半分未満のサイズに圧縮できることを意味する。
パープレキシティ(PPL) : エントロピーやクロスエントロピーを指数関数で表したもの。次のトークンを予測する際の不確実性を測る。不確実性が高いほど、パープレキシティは高くなる
ナット : ネイピア数を底としたパープレキシティ。TensorflowやPyTorchで用いられる
一般的な目安
- より構造化されたデータほど、パープレキシティは低くなる
- 語彙サイズが大きいほど、パープレキシティは高くなる
- コンテキスト長が長いほど、パープレキシティは低くなる
より高精度な大規模モデルほど、さまざまなデータセットで低いパープレキシティを示す。
事後学習により、タスク遂行能力は向上するが、次のトークンを予測する性能は低下することがあるため、パープレキシティは事後学習後に増加する傾向にある。
パープレキシティはデータ汚染の検出や、異常なテキストの検出に利用できる。
厳密な評価
機能正確性の評価 : システムが意図した機能を実行するかどうかを評価すること
コードの機能正確性はユニットテストで検証されてきた。
コード生成のベンチマーク問題はテストケースが用意されている。
ゲームボットならボットが獲得したスコア、エネルギー消費最適化なら節約したエネルギー量で機能正確性を測れる。
対象タスクが機能正確性で評価できない場合、AIの出力を参照データと比較して評価するのが一般的。
参照データは (入力、参照応答)の形式。
人間によるデータ作成は費用がかかるため、AIを用いて参照データを生成するケースが増えている。
2つのテキスト間の類似性の測定方法
- 評価者に判断させる
- 完全一致
- 字句的類似性
- 意味的類似性
単純なタスク以外で完全一致が機能することは稀。
字句的類似性の測定方法は、近似文字列照合、n-gram類似性。
字句的類似性の高さが、必ずしも応答の質の高さに直結しない。
意味的類似性はテキストの埋め込み表現を作成し、2つの埋め込み間の類似性を計算する。
埋め込み表現とは、元データの意味を捉えることを目的とした数値表現
多くのTransformerベースのモデルがモデルの埋め込み層で入力データをベクトル変換してる。
どのような種類のデータでも埋め込み表現をモテる。CriteoはECの製品埋め込みを、Pinterestは画像、グラフ、クエリ、ユーザーの埋め込みを保持してる。
異なるモダリティのデータに対する共同埋め込み(joint embeddings)の開発が進められている。マルチモーダル埋め込み空間。
例) テキスト+画像の埋め込みを作成するCLIP
AI as a Judge
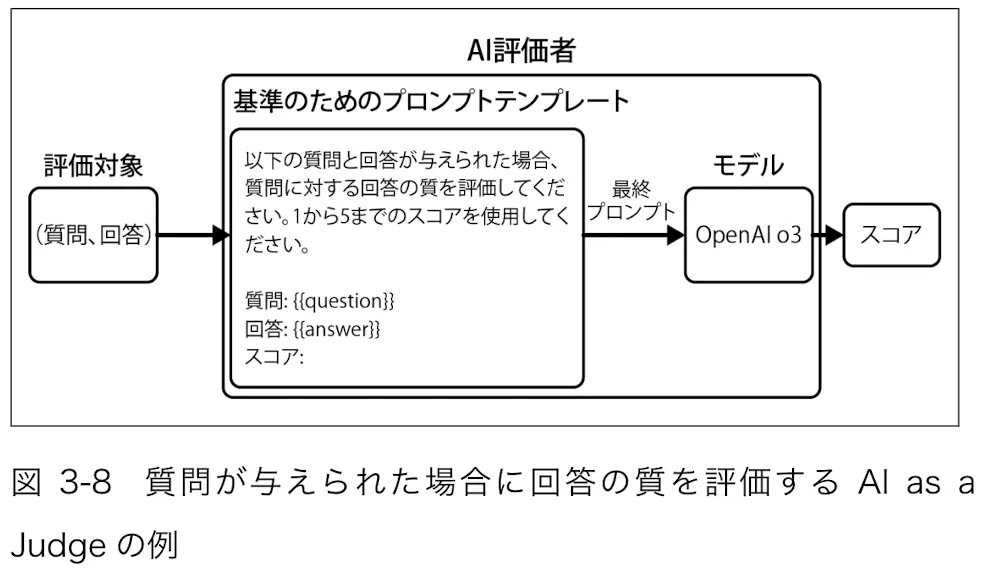
AI(LLM) as a Judge : AIを使ってAIを評価するアプローチ
AI評価者 : 他のAIモデルを評価するために使われるAIモデル
2023年のLangChainのレポートでは、同社のプラットフォームで行われた評価の58%が AI as a Judgeによるものだった。
https://www.blog.langchain.com/langchain-state-of-ai-2023/
なぜAI as a Judgeか?
- 人間の評価者と比較して高速、使いやすく、安価
- 参照データなしで動作するため、参照データがない本番環境でも使用できる
- あらゆる基準に基づいて出力を評価させられる
- 特定のAI as a Judgeは人間の評価者と強く相関する
- 判断の根拠を説明できる
AI as a Judgeの使い方
- 元の質問に基づいて、応答そのものの品質を評価
- 生成応答と参照応答を比較し、両者が同一か評価。類似度指標の代替アプローチ
- 2つの生成応答を比較し、どちらが優れているか、ユーザーがどちらが好みそうか評価
AIツールが提供してるAI as a Judgeの基準は標準化されていない。Azure AI Studioの関連性スコアは、MLflowの関連性スコアは大きく異なる場合がある。
AI as a Judgeのプロンプト作成で明確に記述すべき点
- モデルに実行させるタスク
- モデルが評価を行う際に従うべき基準
- スコアリングシステム(分類、離散値、連続値)
Azure AI Studioの評価
https://learn.microsoft.com/en-us/azure/ai-foundry/concepts/observability?view=foundry-classic
一部のチームがAI as a Judgeを自社システムを評価する他の手段がない場合の代替手段とみなしてる背景
- 非一貫性
- 基準の曖昧さ
- コストとレイテンシーの増加
- AI as a Judgeのバイアス
非一貫性を減らす方法として、プロンプトに評価例を含めることで改善する報告がある。
プロンプトに評価例を含めると、プロンプトが長くなり、推論コストが高くなる。
AI as a Judge自体もAIアプリケーションであるため、時間とともに変化する可能性がある。
評価の比較を行う場合、用いられたAI as a Judgeが完全に同一であると確信できる必要がある。
多くのチームはリスクを軽減する目的で、本番環境でAI as a Judgeをガードレールとして利用してる。
評価者に安価なモデルを使用したり、スポットチェックでコストを削減できる。
AI as a Judgeは他のモデルが生成した応答より、自身が生成した応答を高く評価する傾向(自己バイアス)がある。
多くのAIモデルは先頭位置バイアスが見られる。2つの選択肢を比較する際に最初の回答を好む傾向がある。提示順序を変えて同じテストを複数回繰り返す、プロンプトの工夫で軽減できる。
より長い回答を好む冗長性バイアスを持つ。
評価を行うモデルが、評価対象のモデルよりも低性能でもよいか、は未解決の問題
特化型のAI as a Judge
- 報酬モデル : (プロンプト、応答)のペアを入力とし、生成応答の質をスコアリングする
- 参照ベース評価 : 1つ以上の参照応答と照らし合わせ、生成応答を評価する
- 嗜好モデル : (プロンプト、応答1、応答2)を入力とし、与えられたプロンプトに対して2つの応答のうちどちらが適切か出力する
比較評価によるモデルのランキング
ポイントワイズ評価 : 各モデルを個別に評価し、スコアに基づいてランクづけする
比較評価 : モデル同士を比較し、その結果からランキングを算出する
品質の評価が主観に左右される応答の場合、比較手法のほうがポイントワイズ評価より簡単。
LMArenaのリーダーボードは比較評価が使用されている
https://lmarena.ai/ja/leaderboard
多くのモデルプロバイダーはプロダクション環境のモデルを比較評価してる。
全ての質問に対して好みで回答を選ぶべきではなく、正しさに基づいて回答されるべき
複数のモデルの比較評価を行う場合、レーティングアルゴリズムを用いてランキングを算出する
比較評価の課題
- スケーラビリティのボトルネック
- 標準化と品質管理の欠如
- 比較パフォーマンスから絶対パフォーマンスへ
比較対象となるモデルペアの数は、モデル数に対して二次関数的に増加する。
ランキングアルゴリズムは通常、推移性を前提とするが、AIモデルにも推移性の仮定が当てはまるかは明らかではない。
自社モデルと公開されているモデルの比較評価を行いたい場合、自らデータを収集して独自のリーダーボードを構築するか、公開リーダーボード運営者に料金を支払って評価してもらう必要がある。
Chip氏はLMArenaのランキング操作の試みが一般的になってると指摘してる
標準化を強制する方法
- ユーザーが使用できるプロンプトを事前に決められたセットに限定する
- 信頼できる評価者を起用する
- 比較評価の仕組みを自社製品に組み込み、ユーザーが作業の中でモデルを評価する
4章 AIシステムの評価
Chip氏は費用対効果が不明瞭なAIアプリケーションは非常にありふれていると述べてる。
ChatGPTフィーバーの初期に企業がカスタマーサポートチャットボットを作ったが、その多くはチャットボットがユーザーUX向上につながったか、損なっているか確信を持てずにいる。
初めにアプリケーションがどのように評価されるか理解するアプローチを評価駆動開発とChip氏は呼び、評価がAI導入の最大のボトルネックだと確信してる。
評価基準は、ドメイン固有の能力、生成能力、指示追従能力、コスト、レイテンシーに分類される。
ドメイン固有の能力は、完全一致評価で評価される
効率性はコストも考慮するには、実行時間やメモリ使用量を測定することで評価できる。
コーディング能力ではAI as a Judgeによる主観的な可読性の評価に頼ることになる。
コーディング以外のドメイン能力はクローズドエンドなタスクでよく評価される
2010年代のNLP分野で注目されていた流暢さと一貫性の指標は、言語モデルの生成能力が向上した現在は重要性が薄れた。
生成AIの問題で深刻なのはハルシネーション。
多くのアプリケーション開発者は事実整合性と安全性を重視してる。
事実整合性の検証方法
- ローカルな事実整合性 : 出力をコンテキストに対して評価する
- グローバルな事実整合性 : 出力をオープンな知識に対して評価する
事実整合性を評価するAI as a Judge技術
- 自己検証 : 評価対象の応答と、評価者モデルの応答の一致度を測定。例) SelfCheckGPT
- 知識拡張検証 : 検索エンジンの結果を活用して応答を検証
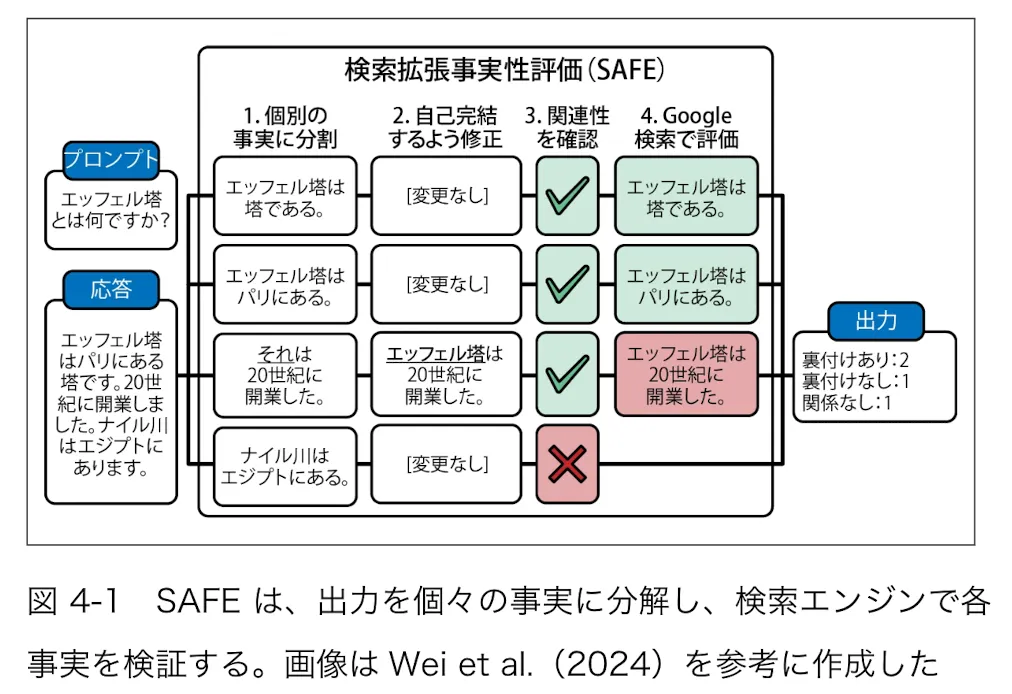
図4-1
テキスト含意認識 : 前提(コンテキスト)に対し仮説(モデルの出力)がどのカテゴリに分類されるか判定するタスク。合意、矛盾、中立のいずれかに分類
安全でないコンテンツの分類
有害性を検出するのに特化した高速で軽量な安価なモデルがある。
指示追従能力とは、「このモデルは与えられた指示にどれだけ上手く従えるか?」を測る
IFEval、INFOBenchのベンチマークで指示追従能力を把握できる
ロールプレイングの目的
- ユーザーが対話するためのキャラクターのロールプレイング
- モデルの出力品質を向上させるためのプロンプトエンジニアリング
RoleLLM、CharacterEvalのベンチマークがロールプレイング能力を評価する
パレート最適化 : 複数の目的を最適化する手法
基盤モデルのレイテンシーメトリクス
レイテンシーはプロンプトやサンプリング変数にも依存する。
多くのアプリケーションでは、コスト管理するために入力と出力トークン数を削減しようとする。
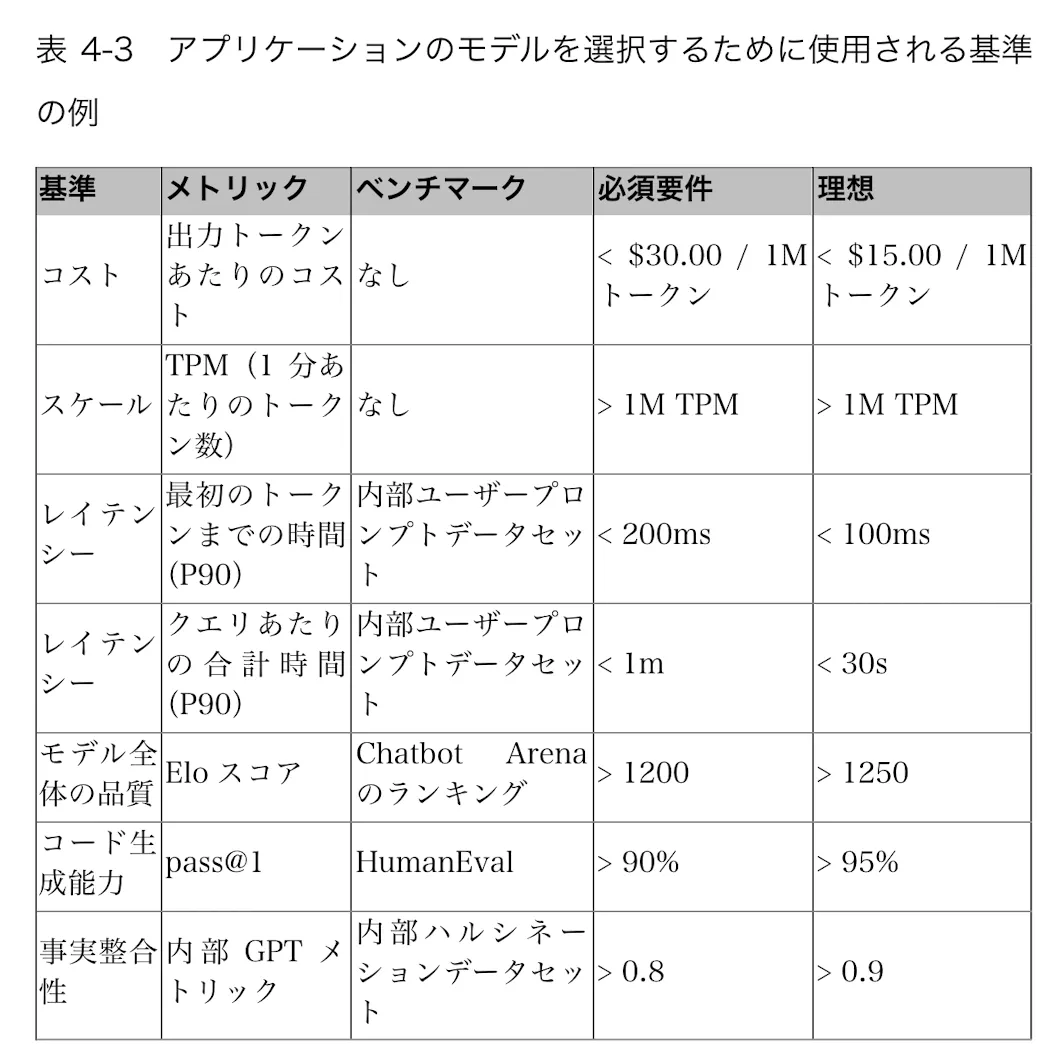
モデル選択
自身のアプリケーションにとってどのモデルが最良かが重要。
モデル選択の評価ワークフロー
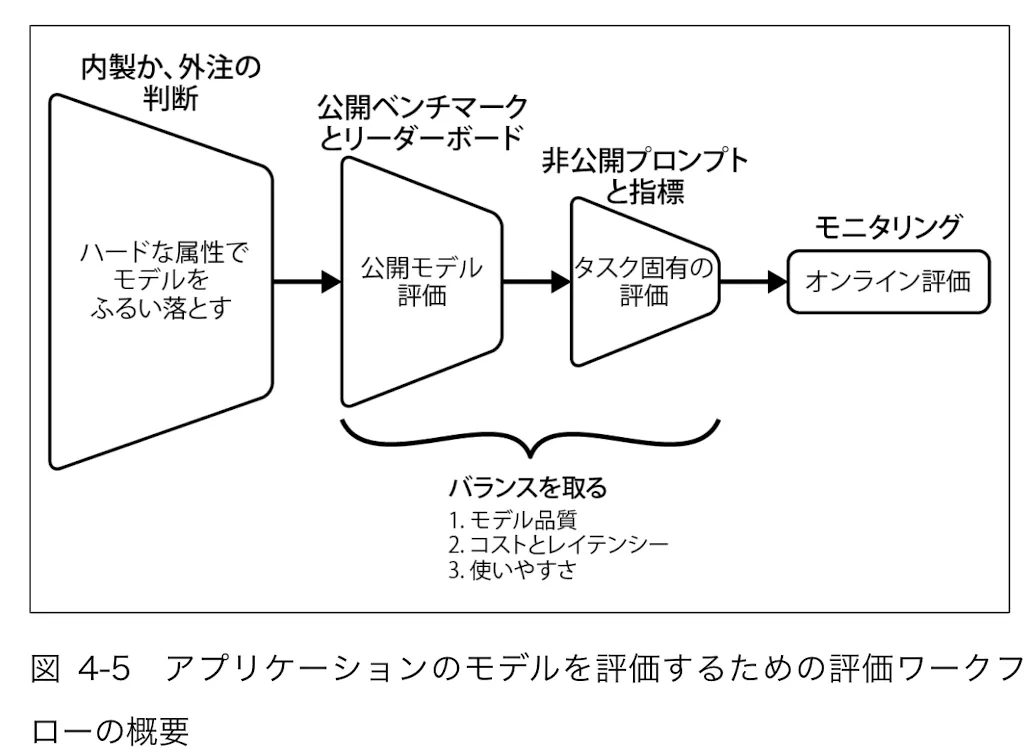
ほとんどの企業は基盤モデルを1から構築することはないため、商用モデルAPIを利用するか、オープンソースモデルを自社でホストするかとなる。
モデルは学習データも公開されている場合にのみオープンと見なされるべきと主張する人がいる。
オープンウェイトはデータが付属していないモデルに使用される。
学習データが公開されると開発者は世間の厳しい目や訴訟リスクにさらされる可能性があるため、意図的に隠すことがある。
オープンソースモデルのライセンスは、異なるライセンスが多用されている。
提供元ごとにモデルの最適化手法が異なる場合があるため、同じモデルでもAPIが違えばパフォーマンスに差が出る可能性がある。
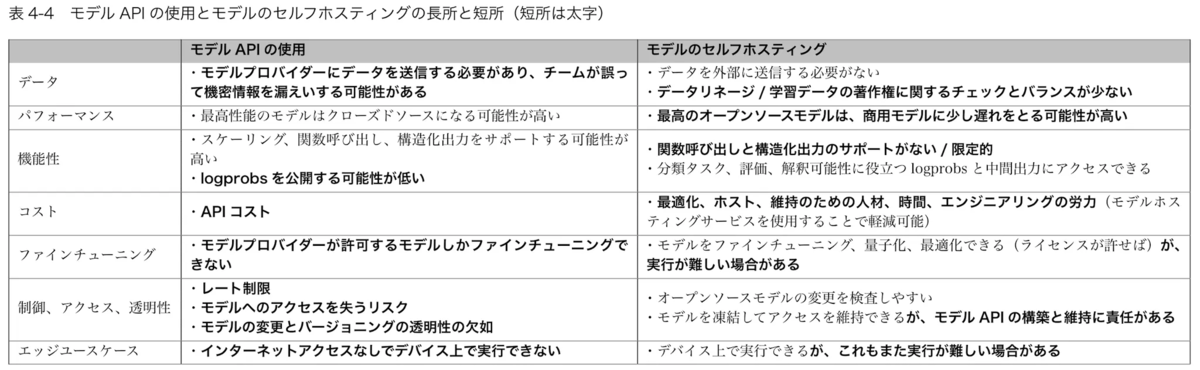
モデルAPIを使用する場合、APIプロバイダーがユーザーのデータを使用して自社のモデルを学習するリスクがある。
2023年8月にZoomがユーザーのサービス生成データをAIモデル学習に使用できるように、利用規約を密かに変更した。
https://techcrunch.com/2023/08/08/zoom-data-mining-for-ai-terms-gdpr-eprivacy/
ほとんどのモデルが、モデルがどのようなデータで学習されたかの透明性がない。
知的財産権の存続がかかっている企業は、AIに関する知的財産法が明確になるまでは、製品作成のサポートにAIを使用するのをためらっている。
オープンソースモデルは開発者のインセンティブが整っていない。
Metaがオープンソースモデルをサポートしてるのは競合他社を牽制するためという見解がある。
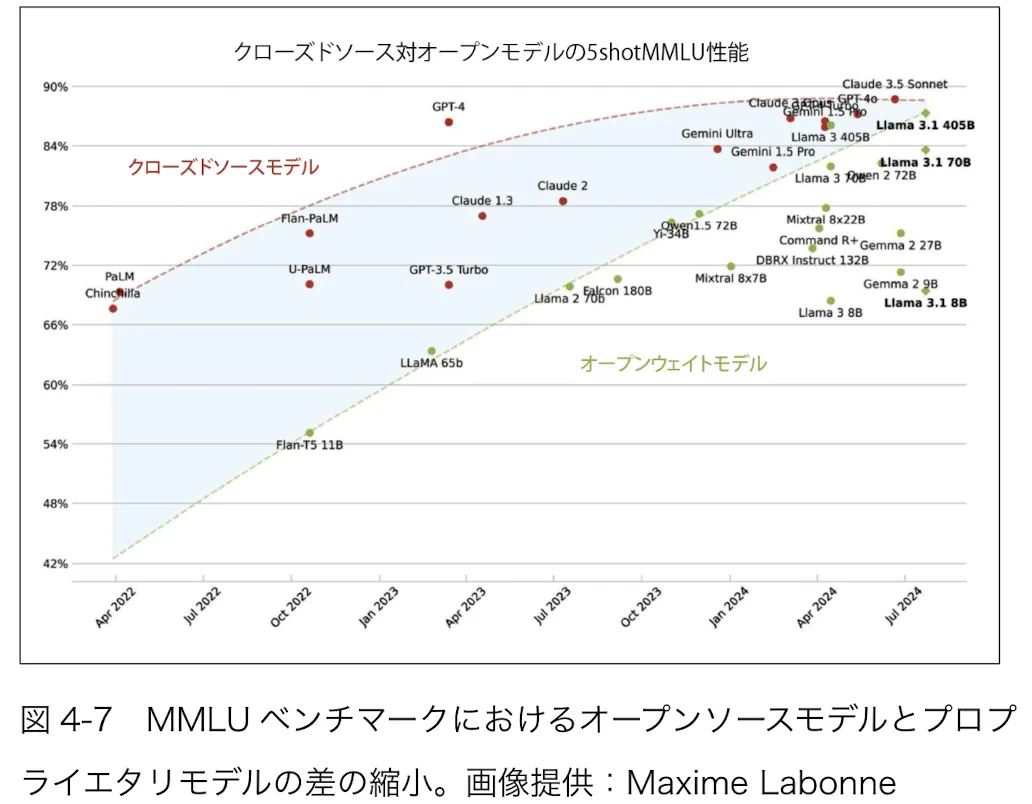
Chip氏は、オープンソースモデルは商用モデルに遅れをとると考えている。
モデルを特定のユースケースで機能させるために必要な機能
- スケーラビリティ
- 外部ツールを使用する能力
- 構造化出力
- 出力ガードレール
多くの企業が必要な機能を提供してるAPIプロバイダーに頼っている。
モデルAPIは従量課金のため、ある程度の規模になるとAPI利用コストがかさむ。
モデルを自社でホストするには、かなりの時間、人材、エンジニアリングの労力が必要。
評価パイプラインの設計
AIアプリケーションの成功には信頼できる評価パイプラインが不可欠。
AIアプリケーションのすべてのコンポーネントを評価し、システムがどこで失敗してるか把握する。
評価ガイドラインの作成
- 評価基準を定義する
- 例を含む採点ルーブリックを作成する
- 評価指標をビジネス指標と紐づける
異なる基準に対する評価手法例
- 有害性検出に小型で特化した分類器
- 応答と元の質問の関連性にはセマンティック類似度
- 応答とコンテキスト間の事実整合性の測定にAI as a Judge
本番環境でも人間による評価は以前として重要
アプリケーションを評価するためにアノテーションをつけたデータセットを準備する。
評価パイプラインの品質で確認すべき項目
- 評価パイプラインは適切な評価結果を得られているか
- 評価パイプラインはどの程度信頼できるか
- 各指標はどの程度相関しているか
- 評価パイプラインによって、アプリケーションのコストとレイテンシーはどの程度増加するか
アプリケーションのニーズとユーザーの行動が変化するにつれ評価基準は進化する。評価パイプラインを反復的に改善していく必要がある。
5章 プロンプトエンジニアリング
プロンプトエンジニアリングとは、モデルが望ましい結果を生成するように指示を作成するプロセス。
Chip氏はプロンプトエンジニアリングはその手軽さから、「大した技術ではない」と誤解されがちと述べている。
プロンプト入門
プロンプトの要素
- タスクの説明
- タスクの実行方法の例
- タスク
どのくらいのプロンプトエンジニアリングが必要になるかは、モデルがプロンプトの小さな変化に対してどれだけ堅牢であるかによる
コンテキス内学習 : プロンプトを通してモデルに実行すべきタスクを教えること。新しい情報を取り込んで判断を下せるようになる。
Few-shot学習 : プロンプト内の例を使ってモデルに学習させること。例が1つも提供されない場合は、Zero-shot学習と呼ぶ
プロンプトのテンプレートの不一致を防ぐためのベストプラクティス
- 基盤モデルへの入力を作成する際は、入力がモデルのチャットテンプレートに従っているか確認する
- サードパーティ製のツールを利用する場合、ツールが正しいチャットテンプレートを使用してるか検証する
- モデルにクエリを送信する前に、最終的なプロンプトを出力し、意図したテンプレートの形式になっているか確認する。
内部的にはシステムプロンプトとユーザープロンプトはモデルに入力される前に連結され、1つのプロンプトになる。
システムプロンプトがユーザープロンプトに比べてパフォーマンスを向上させる、考えられる要因
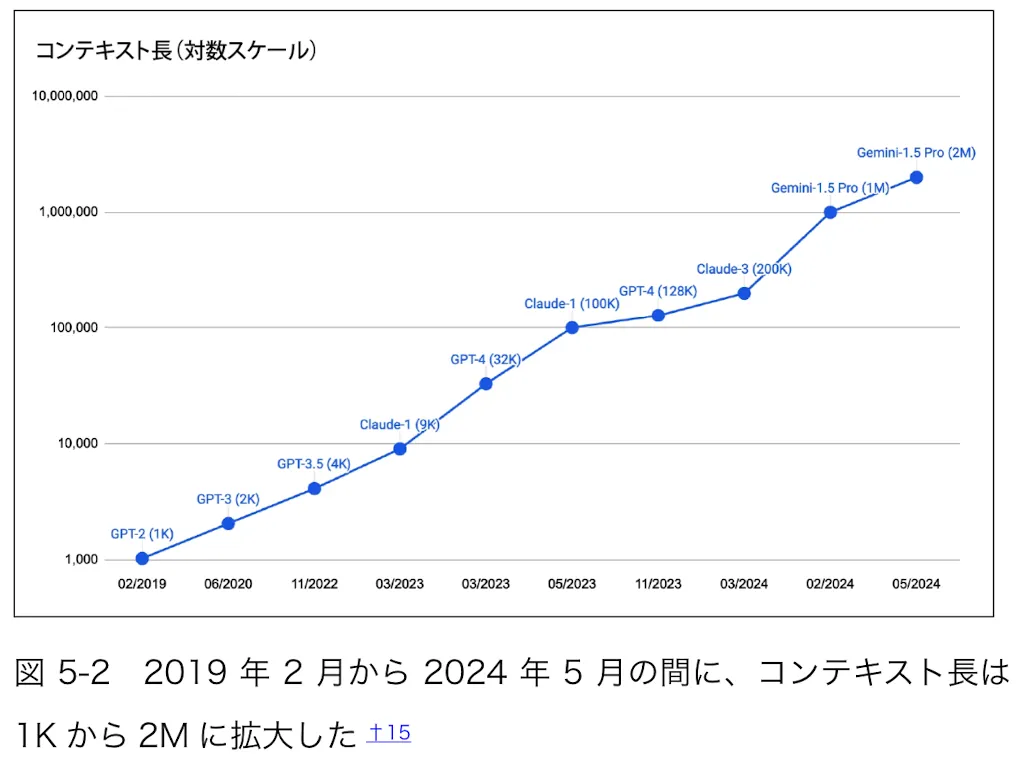
コンテキスト長が100Kで中規模の本1冊分が収まる
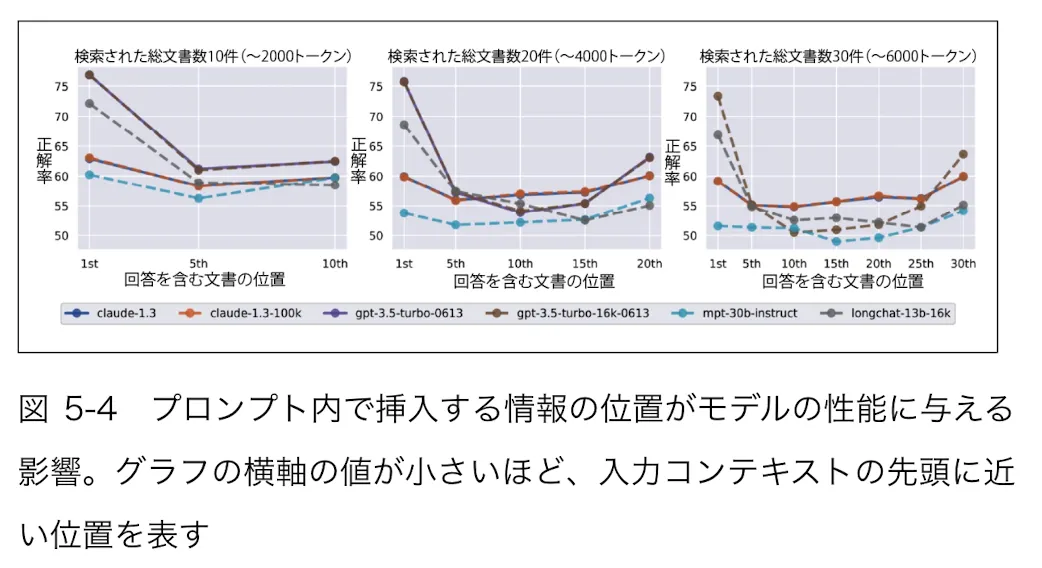
モデルはプロンプトの中央部より、最初と最後に与えられた指示をうまく理解する研究結果がある。
干し草の針(needle in a haystack, NIAH) : プロンプト内のさまざまな場所にランダムな情報を挿入し、モデルに見つけさせる手法。プロンプトの各部分の有効性を評価する方法。
プロンプトエンジニアリングのベストプラクティス
明確で具体的な指示を書く
- モデルに何をさせたいかを曖昧さなく説明する
- モデルにペルソナを与える
- 例を提供する
- 出力フォーマットを指定する
十分なコンテキストを提供する
コンテキスト構築 : 特定のクエリに対して、必要なコンテキストを収集するプロセス。RAGパイプラインのデータ検索、Web検索を使用する。
複雑なタスクをより単純なタスクに分割する
プロンプトを分割することは、監視、デバッグ、並列化、労力の面でメリットがある
ステップごとにモデルを分け、コスト効率を上げることができる。
モデルに考える時間を与える
Chain-of-Thought (CoT) : モデルに段階的に考えるように明示的に指示することで、問題解決に対してより体系的なアプローチをとるようにする手法。CoTは各種ベンチマークで様々な規模のモデルの性能を向上させている。
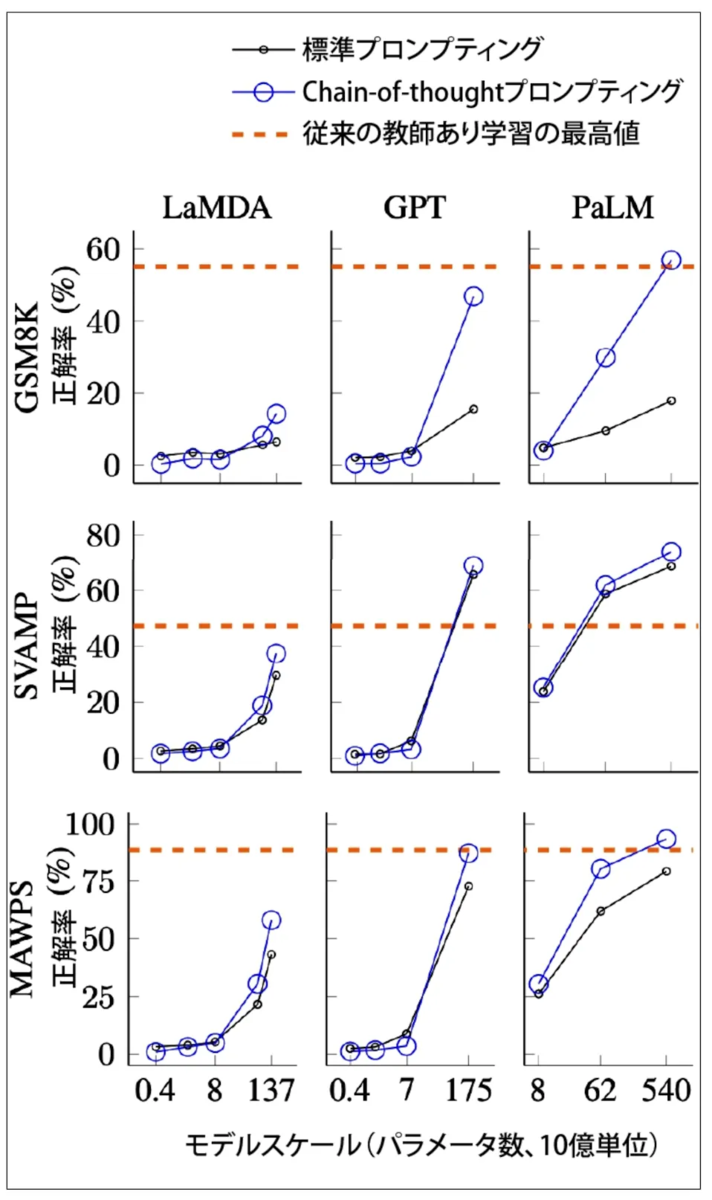
CoTを実践する最も簡単な方法は、「段階的に考えてください」、「判断の根拠を説明してください」という指示を追加すること。実行する手順を具体的に指定することも可能。
自己批判(Self-critique) : モデルに自身の出力を検証させる手法。
プロンプトを反復的に改善する
様々なプロンプトで実験する際は、変更を体系的にテストし、バージョン管理する。
プロンプトエンジニアリングツールを評価する
プロンプトエンジニアリングのワークフロー全体を自動化することを目的としたツールに、OpenPromptやDSPyがある。
プロンプト生成を自動化する一般的なアプローチは、AIモデルを使うこと。
Chip氏は「Keep It Simple」の原則に従い、まずはツールを使わずに自分でプロンプトを作成することをおすすめしている。
プロンプトの整理とバージョン管理
プロンプトをコードから分離するのは、再利用性、テストのしやすさ、可読性、共同作業の面でよい習慣と言える。
多くのチームでは独立したプロンプトカタログで各プロンプトを明示的にバージョン管理している。プロンプトカタログには各プロンプトに関連するメタデータを付与し、プロンプトを検索可能にする機能が必要。
プロンプトチュートリアル
- OpenAI : https://platform.openai.com/docs/guides/prompt-engineering
- Anthropic : https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-4-best-practices
- Meta : https://www.llama.com/docs/how-to-guides/prompting/
- Google : https://services.google.com/fh/files/misc/gemini-for-google-workspace-prompting-guide-101.pdf
プロンプトライブラリ
- Anthropic : https://platform.claude.com/docs/en/resources/prompt-library/library
- Google : https://console.cloud.google.com/vertex-ai/studio/prompt-gallery
- OpenAI : https://platform.openai.com/docs/examples
防御的プロンプトエンジニアリング
アプリケーション開発者が防御すべきプロンプト攻撃
- プロンプト抽出
- ジェイルブレイクとプロンプトインジェクション
- 情報抽出
破壊的なリスク
- リモートコードまたはツールの実行
- データ漏洩
- 社会的危害
- 偽情報
- サービスの中断と転覆
- ブランドリスク
プロンプトリバースエンジニアリング : 特定のアプリケーションで使われているシステムプロンプトを推測するプロセス。コンテキストも抽出される可能性がある。
モデルのジェイルブレイク : モデルが持つ安全機能を回避しようとする試み
プロンプトインジェクション : ユーザープロンプトに悪意のある指示を紛れ込ませる攻撃手法
手動プロンプトハッキングのテクニック
- 攻撃者がキーワードのスペルを意図的に間違える難読化。特殊文字をプロンプトに挿入しモデルを混乱させる
- 出力フォーマットを操作し、予期しない形式の文章を生成させる
- 攻撃者が特定の役割やシナリオを演じるように指示をするロールプレイング
自動化された攻撃
- プロンプトの一部をランダムな文字列に置き換え、有効なバリエーションを見つける
- 既存の攻撃手法をもとに、モデル自身に新しい攻撃手法を提案させる
- 攻撃用のAIでプロンプトを改善し、標的のAIから特定の好ましくないコンテンツを引き出す
間接的プロンプトインジェクション
- 受動的フィッシング : 攻撃者が悪意のあるペイロードを、WebページやGitHubリポジトリに仕込み、モデルがWeb検索などのツールで発見するのを待つ
- 受動的インジェクション : 攻撃者が能動的に各標的に脅威を送りつける。悪意のある指示を含んだメールを標的に送り、メールアシスタントに悪意ある指示を読み込ませる
多くのLLMは自然言語をSQLに翻訳できるため、攻撃者はSQLコマンドを記述せずにデータベースシステムに悪意あるSQLを実行できる。
言語モデルが知識を引き出せる機能を悪用される例
- データ盗用
- プライバシー侵害
- 著作権侵害
プロンプ攻撃に対するシステムの堅牢性を評価する指標
- 侵害性 : すべての攻撃の試みのうち、成功した攻撃の割合
- 誤拒否率 : 安全に応答できるはずのクエリをモデルが拒否してしまう頻度
プロンプトで防御する簡単な方法は、システムプロンプトをユーザープロンプトの前後で2回繰り返す方法。
システムで生成したコードを実行する必要がある場合は、ユーザのメインマシンとは切り離された仮想マシン内のみで実行するようにする。
影響の大きいコマンドを人間による明確な承認なしに実行させない防御もある。
入力側だけでなく、出力側にもガードレールを設けるのが不可欠
6章 RAGとエージェント
RAG
RAG : 外部リソースから関連情報を検索することでモデルの生成を強化する技術。外部リソースは内部データベース、ユーザーの過去のチャット履歴、インターネットなど。
「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」で初めてRAGという用語が提唱された。
https://arxiv.org/abs/2005.11401
RAGはすべてのクエリに同じコンテキストを使用するのではなく、各クエリに固有のコンテキストを構築する技術と考えられる。
基盤モデル初期のRAGの目的は、モデルのコンテキスト長の制限を克服すること。
Chip氏は「アプリケーションのコンテキストは、それが使用するモデルがサポートするコンテキストの限界まで膨張する」と述べている。
コンテキストが長ければ長いほど、モデルはコンテキストの間違った部分に焦点を当てる可能性が高くなる。
Anthropicは「ナレッジベースが200000トークン(約500ページの資料)より小さい場合は、RAGを必要とせず、モデルに与えるプロンプトにナレッジベース全体に含めるだけでよい」と提案してる。
https://www.anthropic.com/engineering/contextual-retrieval
RAGシステム
- リトリーバー : 外部のリソースから情報を検索する
- ジェネレーター : 検索された情報に基づいて応答を生成する
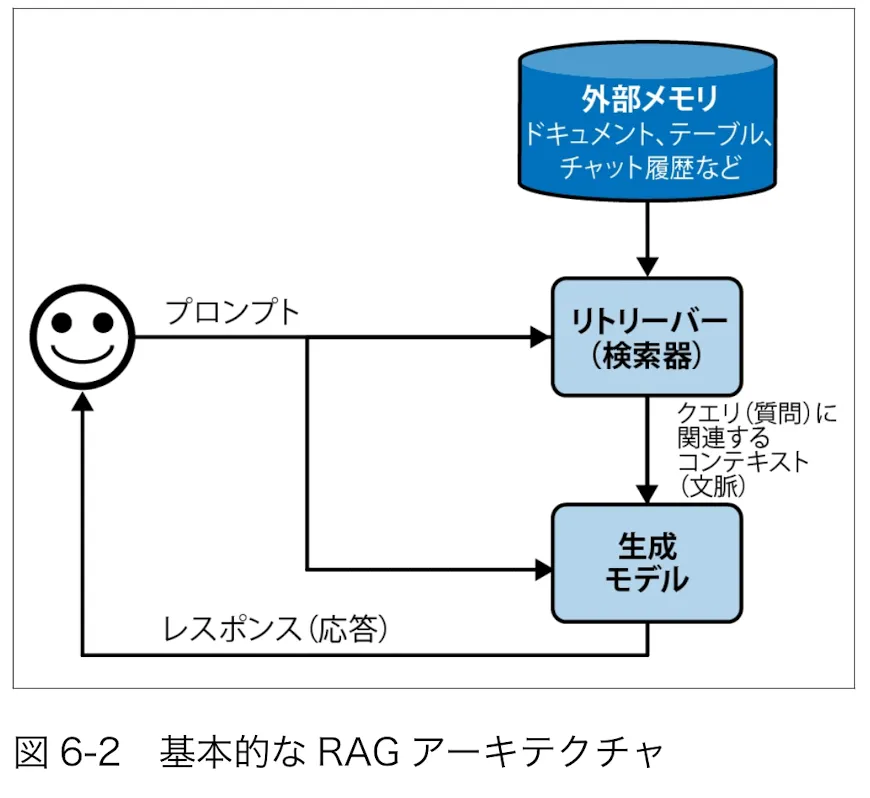
RAGシステムの成否はリトリーバーの品質にかかっている。
リトリーバーは、インデックス作成とクエリ実行の2 つの機能がある。
ドキュメントを管理しやすいチャンクに分割し、最も関連性の高いデータチャンクを取得する。
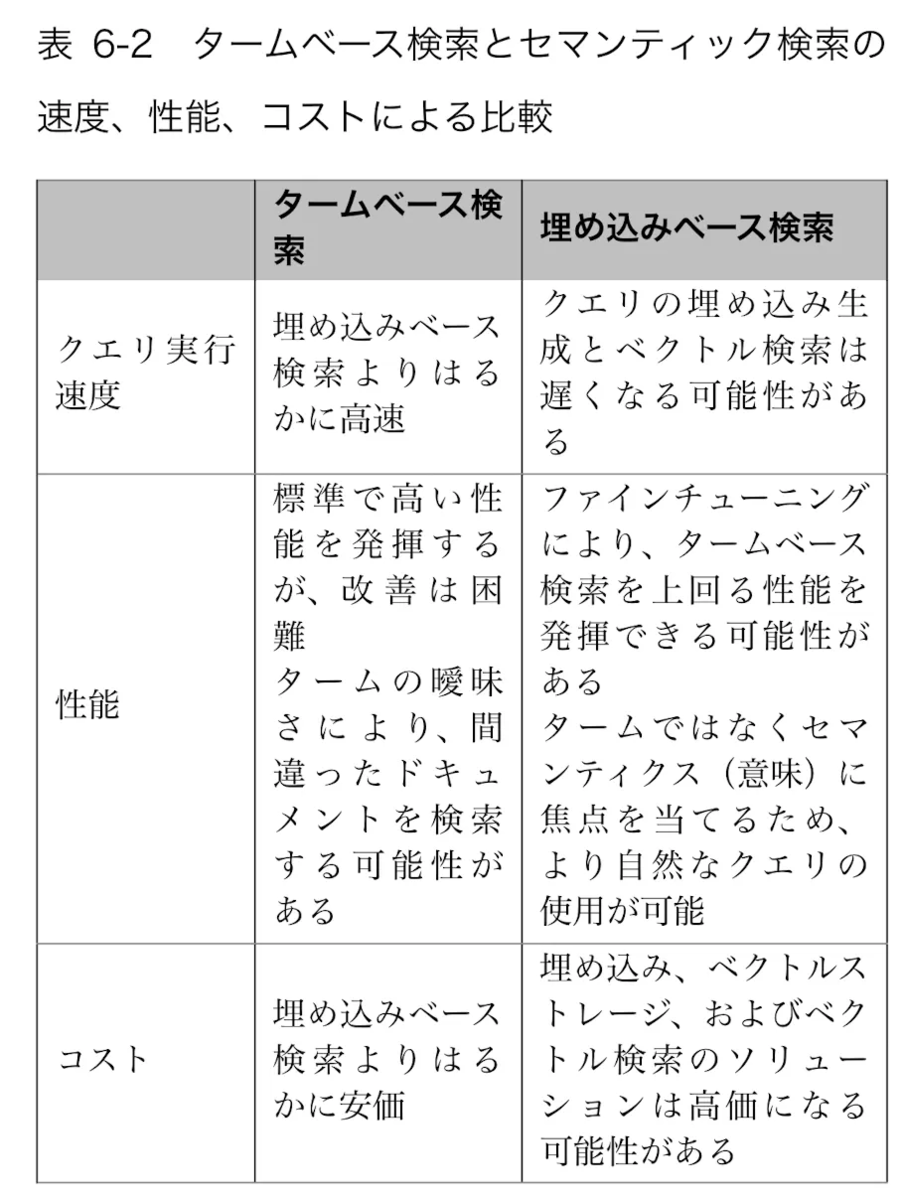
タームベース検索(lexical retrieval) : クエリが与えられた時、キーワードを使用して関連するドキュメントを見つける方法。意味ではなく語彙レベルで関連性を検索する。
タームベース検索の問題
- モデルのコンテキスト長を超える、多くのドキュメントが指定されたタームを含んでいる可能性がある。ヒューリスティックな解決策は、対象タームを最も多く含むドキュメントを選ぶこと。ドキュメント内でタームが現れる回数をターム頻度(term frequency : TF)と呼ぶ
- プロンプトが長く、多くのタームを含む可能性がある。重要なタームを指定する方法が必要になる。
逆文書頻度(inverse document frequency : IDF) : タームの重要度が出現するドキュメント数に反比例する指標
Elasticsearch、BM25がタームベース検索で代表的なソリューション
BM25は業界で広く利用されていて、高度な検索アルゴリズムと比較する際のベースラインとなる。
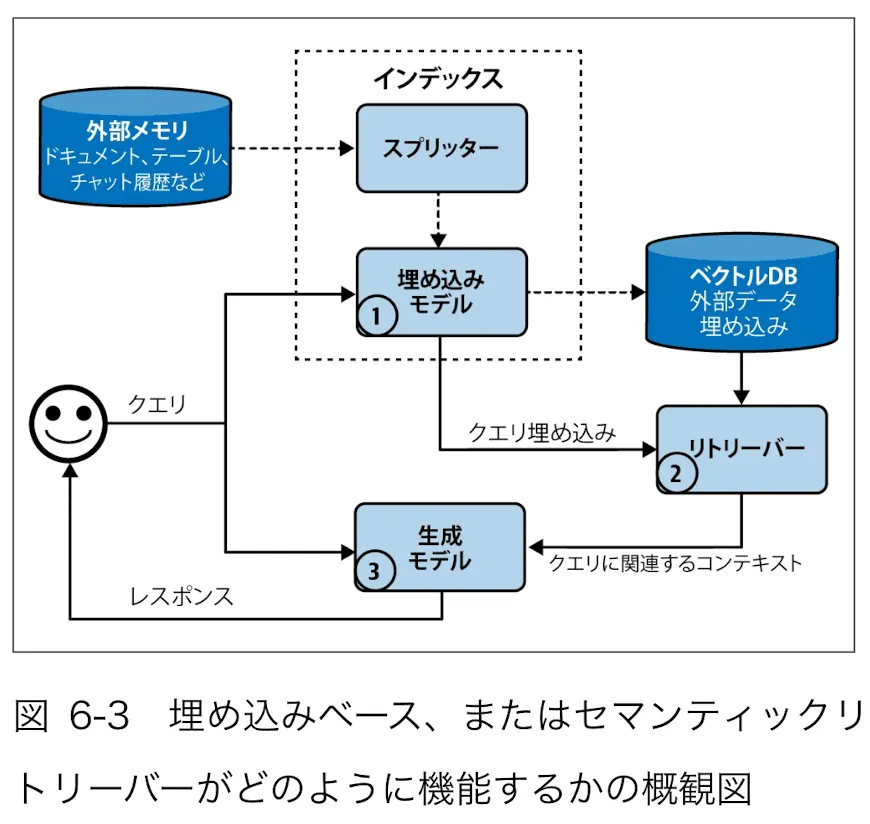
埋め込みベース検索: 文書の意味とクエリの意味の近さに基づいて文書を検索する。
埋め込みを保存するデータベースはベクトルデータベース
ベクトルデータベースはベクトル検索機能が重要。ベクトルデータベースは生成AI特有のものではない。
ベクトル検索は、近似最近傍探索問題として捉えられる。
ベクトル検索ライブラリとして、FAISS、ScaNNがある。
主要なベクトル検索アルゴリズムは、LSH(局所性鋭敏型ハッシュ)、HNSW(Hierarchical Navigable Small World)、直積量子化、IVF(転置ファイルインデックス)、Annoy(Approximate Nearest Neighbors Oh Yeah)
タームベース検索の利点
- インデックス作成、クエリ実行の両方で、埋め込みベース検索より高速
- 初期設定のままでも十分機能する
埋め込みベース検索の利点
- 改善を重ねることで、タームベース検索の性能を上回る可能性がある
RAG評価フレームワークでよく使用される指標
- コンテキスト精度 : 検索されたドキュメントのうち、クエリに関連するものの割合
- コンテキスト再現率 : クエリに関連するすべてのドキュメントのうち、検索されたものの割合
タームベース検索と埋め込みベース検索を組みわせることをハイブリッド検索と呼ぶ。
検索ソリューションの評価
- どのような検索メカニズムをサポートしているか。ハイブリッド検索はサポートしているか
- どの埋め込みモデルとベクトル検索アルゴリズムをサポートしているか
- データストレージとクエリトラフィックの両面で、どの程度スケーラブルか
- データのインデックス作成にどれくらいの時間がかかるか、一度に一括で処理できるデータ量はどれくらいか
- 異なる検索アルゴリズムに対するクエリのレイテンシーはどれくらいか
- 価格体系はどうなっているか
表形式データのRAGワークフロー
エージェント
AIの最終目標はインテリジェントエージェントであると多くの人が考えている。
AIエージェントは新しい分野で、定義、開発、評価するための確立された理論的フレームワークは存在しない。
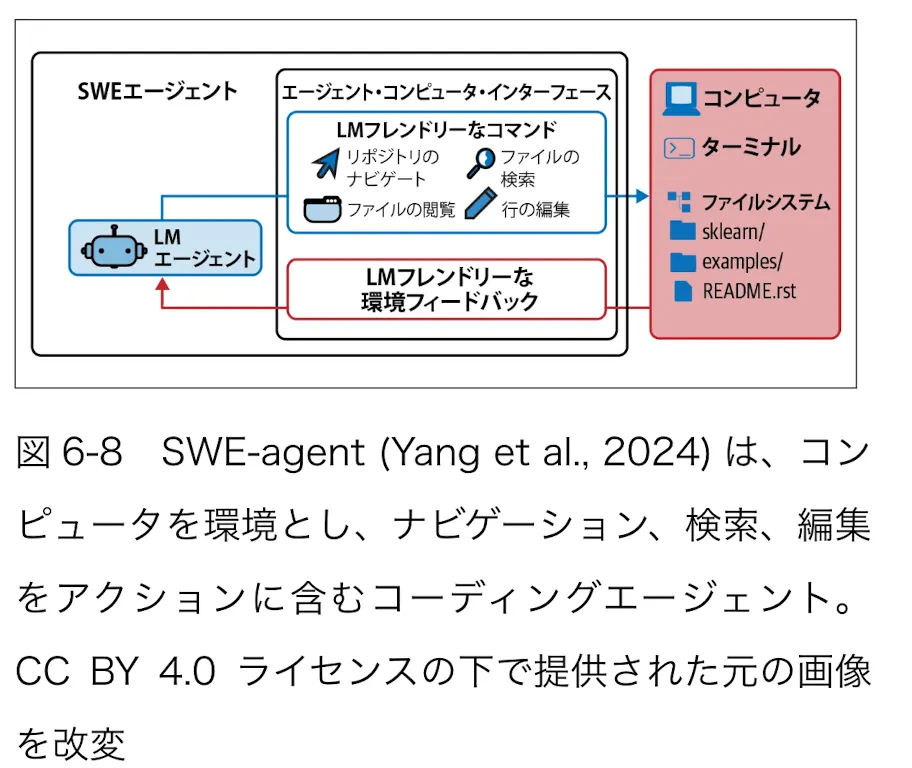
エージェントとは、自らが置かれた環境を認識し、環境に作用することができるあらゆるもの
エージェントは、動作する環境と、実行できる一連のアクションによって特徴付けられる。
環境は、ユースケースによって定義される。例えばドキュメントのスクレイピングエージェントなら、環境はインターネットになる。
一連のアクションは、アクセスできるツールによって拡張される
エージェントが強力なモデルを必要とする理由
- エラーの累積 : タスクを達成するために複数のステップを実行することが多く、ステップ数が増えるにつれて全体の精度が低下する。
- より高いリスク : ツールにアクセスすることで、失敗した場合の結果がより深刻になる
ツールが多くなるほどエージェントの能力は高まるが、十分に理解して活用することが難しくなる。
検討すべきツールカテゴリ
- 知識拡張
- 能力拡張
- 書き込みアクション
複雑なタスクにはプランニングが必要。
無駄な実行を避けるために、プランニングは実行から切り離すべき。エージェントにまずプランを生成させ、プランが検証された後にのみ、実行させる。
プランの生成、検証、実行の3つのコンポーネントを持つ
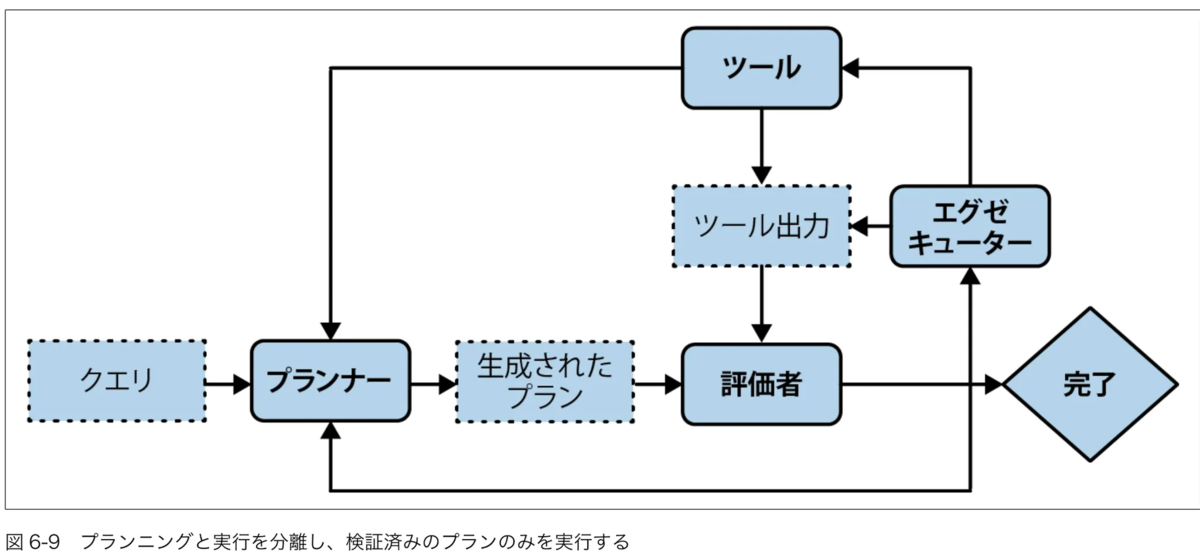
タスク解決のプロセス
- プラン生成
- リフレクションとエラー修正 : 生成されたプランを評価する
- 実行
- リフレクションとエラー修正 : 実行結果を評価し、目標が達成されたか判断する。
プランニングは探索問題
自己回帰モデルは順方向のアクションしか生成できず、代替アクションを生成するためにバックトラックすることはできないと主張する人もいる。
プランの制御フロー
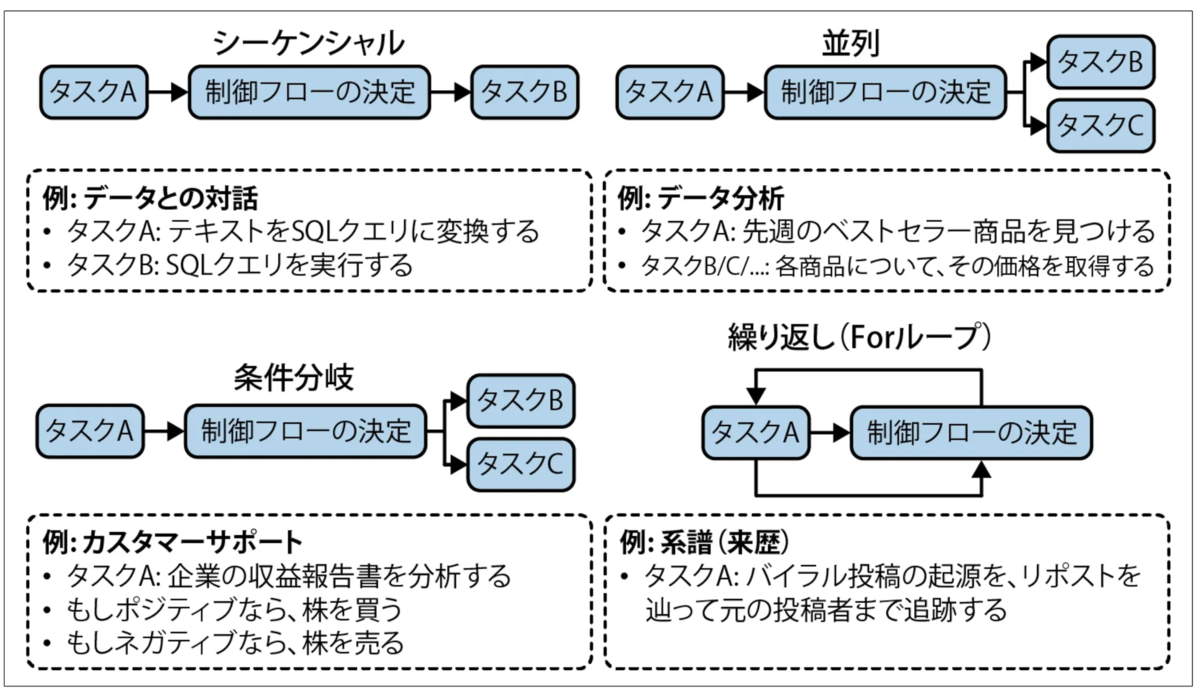
リフレクションが役立つ場面
- ユーザーのクエリを受けとった後、リクエストが実現可能か評価
- プランを生成した後、プランが妥当か評価
- 各実行ステップの後、計画通りに進んでいるか評価
- プラン全体が実行された後、タスクが達成されたか評価
ReAct : 推論と行動を交互に行う手法。エージェントにおける一般的なパターンとなっている。
https://arxiv.org/abs/2210.03629
プランニングの失敗パターン
- 無効なツール
- 有効なツール、無効なパラメータ
- 有効なツール、不正なパラメータ値
- 目標の未達
- 時間がかかりすぎる
エージェントの効率性の評価
- タスクを完了するために、平均して何ステップかかるか
- タスクを完了するために、平均してどれくらいコストがかかるか
- 各アクションがどれくらい時間がかかるか
別のエージェントや人間のオペレータをベースラインとして比較できる。
記憶
記憶とは、モデルが情報を保持し、利用することを可能にする仕組み。
AIモデルの主要な記憶メカニズム
- 内部知識 : モデル自体が記憶知識で、学習データからの知識を保持。モデルは全てのクエリでこの知識にアクセスできる
- 短期記憶 : モデルに与えられたコンテキスト。
- 長期記憶 : RAGシステムのような、モデルが検索を通じてアクセスする外部データソース。複数のタスクを横断して保持。
AIモデルを記憶システムで拡張することの利点
- セッション内の情報オーバーフローの管理 : エージェントが取得する情報が最大コンテキスト長を超える可能性がある。
- セッション間での情報の永続化 : 会話履歴にアクセス
- モデルの一貫性の向上 : AIモデルが以前の回答を参照できれば、後続の回答を調整できる
- データ構造の完全性の維持
7章 ファインチューニング
ファインチューニングの概要
事前学習済みモデルを高度なタスク固有のデータでファインチューニングする前に、安価なタスク関連データを用いて自己教師あり学習でファインチューニングできる。
自己教師ありファインチューニングは、継続的な事前学習と呼ばれる。
教師ありファインチューニングは、(入力、出力)のペアを使って学習する。
モデルをファインチューニングして、コンテキスト長を拡張することも可能。ロングコンテクストファインチューニングでは、位置埋め込みを調整するなど、モデルのアーキテクチャの変更が必要。
いつファインチューニングするのか
ファインチューニングの目的は、汎用的な能力とタスクに特化した能力の両面でモデルの品質を向上させること。JSONやYAML形式のような特定の構造に沿った出力形式にする目的でも使われる。
ファインチューングにより基盤モデルが持っているバイアスが緩和された結果がある。
蒸留 : 大規模モデルが生成したデータを使って、その振る舞いを模倣するように小規模モデルを学習すること
多くのモデル改善は、ファインチューニングせずともある程度達成できる。
特定のタスクに合わせてモデルをファインチューニングすると、そのタスクの性能は向上するが、他のタスクの性能が下がる可能性がある。
この場合は、対応した全てのタスクでモデルをファインチューニングするか、タスクごとに個別のモデルを使用する。
ファインチューニングに必要な、多額の初期投資と継続的なメンテナンス
- データ : アノテーション付きデータを手作業で収集するのは時間がかかり、コストも高くなる
- モデルの学習方法に関する知識
- サービング方法の検討
- モデルのモニタリング、メンテナンス、アップデートに関する方針と予算の確立
Chip氏はAIエンジニアリングの実験は、まずはプロンプティングか始めるべきと指摘してる。
現場の実態としては、プロンプトの実験はごくわずかで、場当たり的。指示は不明確で、例としたデータは実態を反映しておらず、評価指標の定義も不十分。
汎用モデルの能力が向上するにつれて、ドメイン特化タスクへの対応能力も向上し、ドメイン特化モデルの性能を上回ることがある。
ファインチューニングの利点としてトークン使用量を最適化できる点があったが、プロンプトキャッシングが登場した現在では、ファインチューニングの利点とは言えなくなった。
RAGとファインチューニングどちらに取り組むべきかは、モデルの失敗が「情報に起因するもの」か「振る舞いに起因するもの」かによって決まる。
モデルが情報不足によって失敗する場合、関連する情報源へのアクセスを可能にするRAGシステムが有効。
情報不足の失敗が起こるシナリオは、モデルが情報を持っていないか、モデルが古い情報を持っているかのどちらか。
モデルの振る舞いに問題がある場合は、ファインチューニングが有効なことがある。
ファインチューニングは「形式」のため、RAGは「事実」のため
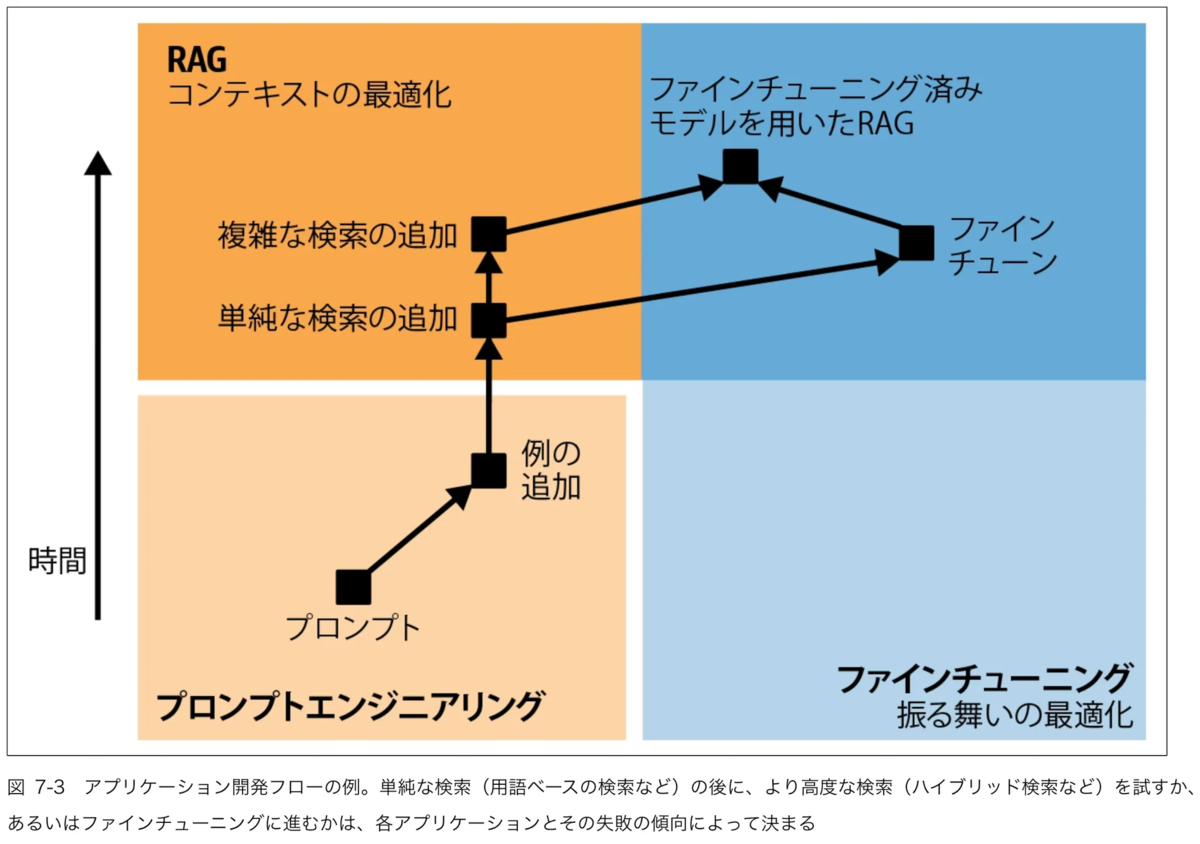
メモリのボトルネック
メモリのボトルネックを理解するための要点
- 基盤モデルは規模が大きいため、推論とファインチューニングの両方でメモリがボトルネックになる。学習の方が推論時よりも必要なメモリが多くなる
- ファインチューニング時のメモリフットプリントの要因は、パラメータ数、学習可能パラメータ数、数値表現
- 学習可能パラメータが多いほど、メモリフットプリントは増大する。学習可能パラメータを削減するアプローチがPEFTの目的
- 量子化とはモデルをビット数が多い形式から少ない形式へ変換する手法
- 推論は通常、できるだけすくないビット数で行われる
- 学習は数値精度の影響を受けやすいので、低精度でのモデル学習は困難になる。学習は混合精度で行われる。
推論に必要なメモリ
モデルのパラメータ数をN、各パラメータに必要なメモリをMとすると、モデルを読み込むために必要なメモリは N*M。
フォワードパスで保持する必要があるアクティベーションとkey-valueベクトルに必要なメモリは、モデルの重みに必要なメモリの20%程度と見積もれる。
この仮定を元にすると、N * M * 1.2 のメモリが必要
ex) 130億パラメータ、各パラメータ2バイトのモデルでは、130億 * 2バイト * 1.2 = 31.2GBのメモリが推論に必要
訓練に必要なメモリ
訓練メモリ=モデルの重み + アクティベーション + 勾配 + オプティマイザの状態
ex) Adamを使って130億パラメータモデル。各学習可能パラメータは勾配、オプティマイザの状態保存のために3つの値を持つ。各値の保存に2バイト必要とすると、130 * 3 * 2 バイト= 78GB
ファインチューニングのテクニック
コンシューマー向けGPUメモリは12~24GBほどで、ハイエンドなGPUでも48GB程度。
70億パラメータのモデルの学習には56GBのメモリが必要になるので、メモリ不足が問題になる
PEFT (Parameter Efficient Finetuning) : パラメータ効率のいいファインチューニング技術。「パラメータ効率がいい」の明確な閾値はないが、一般的にはフルファインチューニングより数桁少ない学習パラメータで同等の性能を達成できる技術をさす
PEFTを初めて提唱した論文では、モデルの適切な場所に追加のパラメータを挿入する方法が提案された。
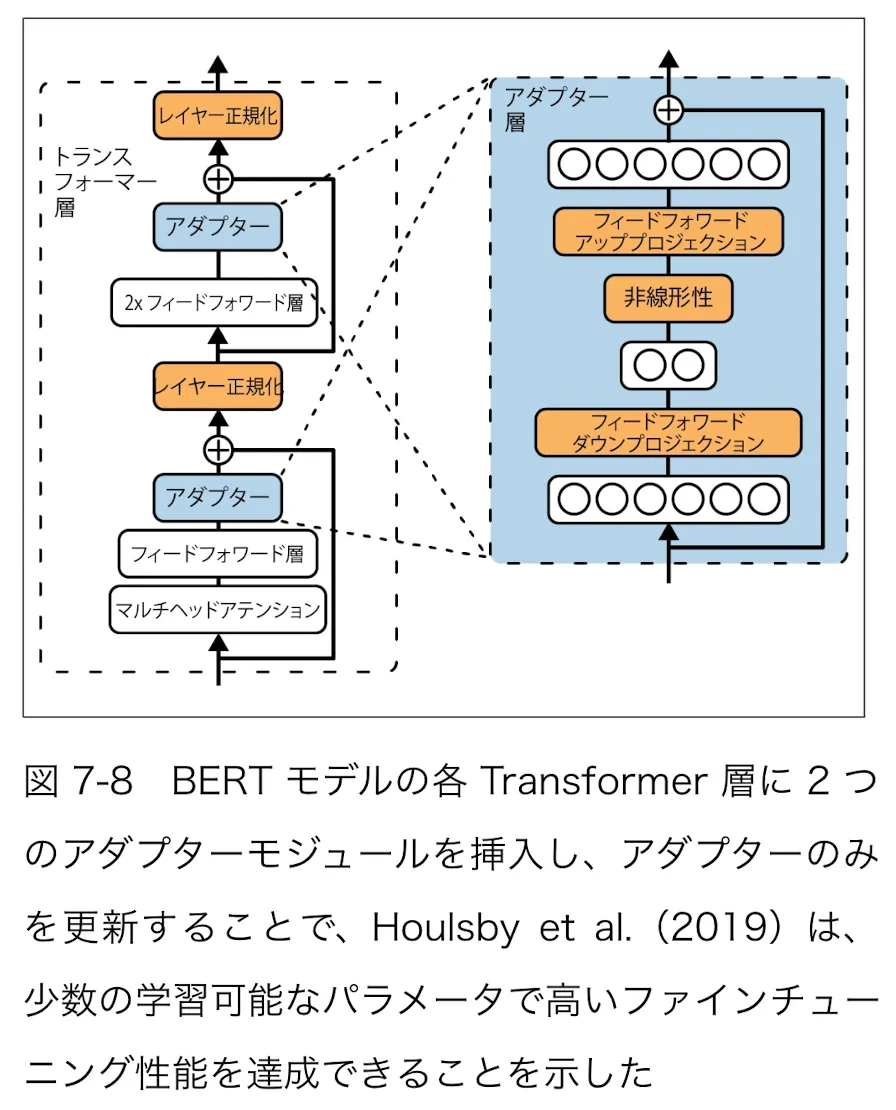
アダプターの学習だけで、フルファインチューニングの学習パラメータ数の3%程度で、性能さ0.4%以内の結果が得られた。
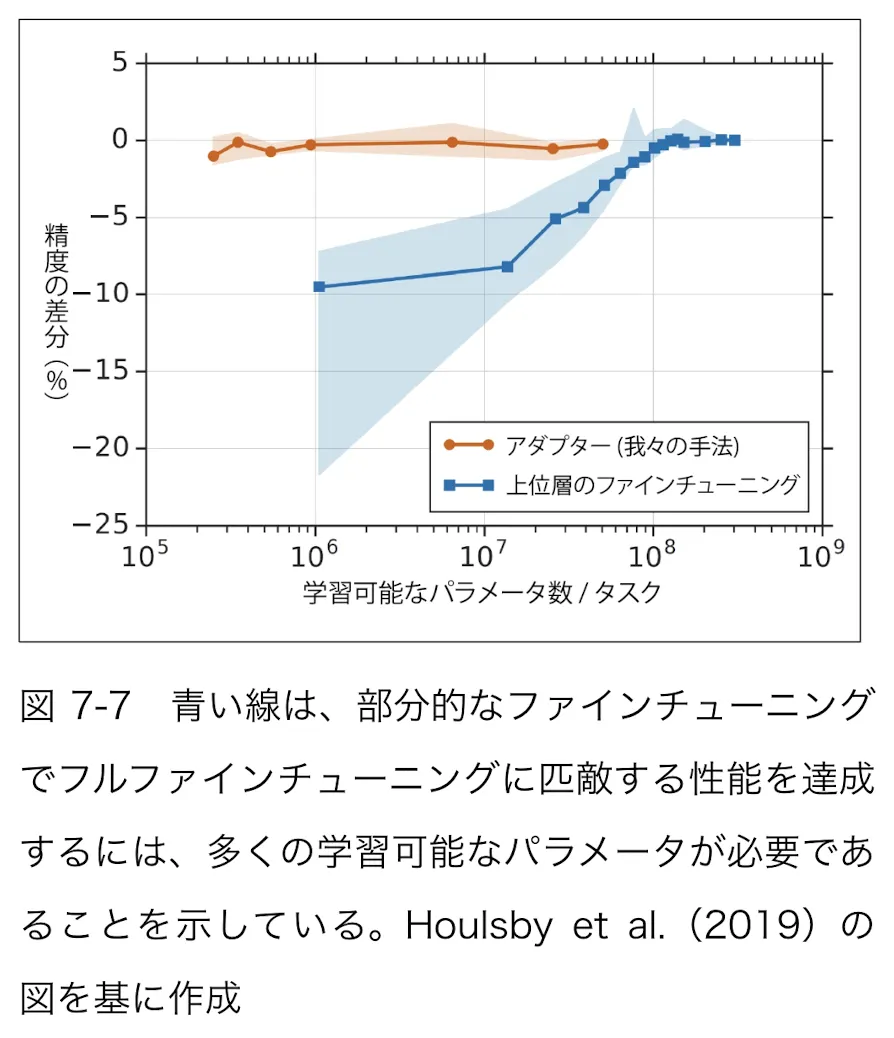
アダプター追加の欠点は、推論レイテンシーが増加すること。
LoRA(Low-Rank Adaptation)が最も普及したアダプターベースの手法。他には、BitFit、IA3がある。
PEFTには学習可能な特別なトークンを導入し、モデルによる入力の処理方法を変更するソフトプロンプトベースの手法もある。
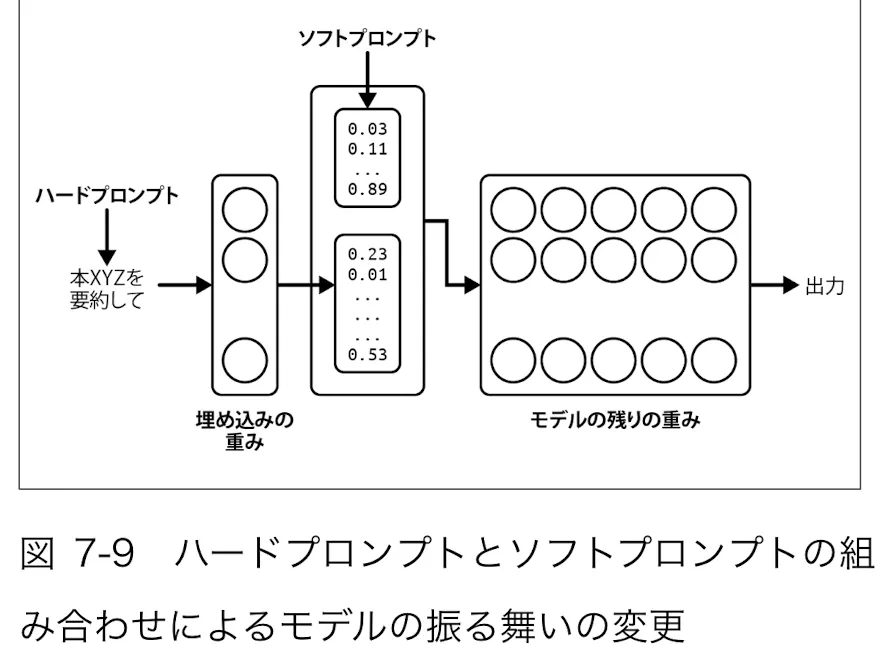
多くの論文でLLMは多数のパラメータを持つ一方、固有次元は低いと論じられている。
固有次元 : モデルが実際にタスクを学習するために必要な実行的なパラメータ数。
事前学習がモデルの固有次元を暗黙的に最小化することを示す。
LLMがよく学習されている程、少ない学習可能パラメータと少量のデータでモデルをファインチューニングするのが容易になる。
Chip氏は低ランクでの学習に切り替える前に、どの程度のフルランク学習が必要なのか正確に知ることは興味深い研究テーマと述べてる。
Appleは複数のLoRAアダプターを使用して、同じ30億パラメータのベースモデルをiPhoneのさまざまな機能に適応させている。デバイス上にモデルをサービングしてるらしい。
https://machinelearning.apple.com/research/introducing-apple-foundation-models
ファインチューニングのハイパーパラメータ
- 学習率
- バッチサイズ
- エポック数
- プロンプト損失の重み
8章 データセットエンジニアリング
AI開発におけるデータの注目が高まり、Data Centric AIという考えが登場。
Model Centric AIではモデル自体を強化することでAIのパフォーマンスを向上させようとする一方、Data Centric AIはデータを強化することでAIのパフォーマンスを向上させる。
データキュレーション
質の悪いデータはモデルの能力、バイアス、ハルシネーションを増大させる。
データ形式
- 自己教師ありファインチューニングは、連続したデータ
- 指示ファインチューニングは、(指示、応答)形式のデータ
- 選好ファインチューニングは、(指示、勝利応答、敗北応答)形式のデータ
- 報酬モデルは、((指示、応答), スコア)形式のデータ
少量の高品質なデータが、ノイズの多い大量のデータよりも優れた性能を発揮することがある。
データが高品質とみなせる特性。ただし、詳しい要件は人によって異なる。
- 関連性 : 訓練サンプルはモデルに学習させるタスクに関連してる必要がある。
- タスク要件との整合性 : アノテーションがタスクの要件と整合してる必要がある
- 一貫性 : アノテーションはサンプルごと、アノテーター間で一貫している必要がある
- 正しいフォーマット : 全てのサンプルはモデルが期待するフォーマットに従う必要がある。
- ユニーク性 : データセット内のサンプルが一意である必要がある
- コンプライアンス : データが社内外に関連する全てのポリシーに準拠してる必要がある
必要なデータ量に与える要因
- ファインチューニング技術 : 数万、数百万の(指示、応答)ペアがある場合はフルファインチューニング、数百から数千のサンプルしかない場合はPEFTが最適の可能性が高い
- タスクの複雑さ : 単純なタスクは複雑なタスクより少ないデータで済む
- ベースモデルのパフォーマンス : ベースモデルが望ましいパフォーマンスに近いほど、必要なサンプル数は少なくなる
ほとんどのケースでは、50~100件のサンプルでファインチューニングした後に改善が見られる
必要な高品質データ量を減らすアプローチ
- 自己教師あり→教師あり
- 関連性の低いデータ→関連性の高いデータ
- 合成データ→実データ
必要なデータ数を見積もるには、データセットのサブセットでモデルをファインチューニングし、パフォーマンスがデータセットサイズとともにどのように向上するかをプロットし、データセットサイズの増加に伴う勾配で判断する。
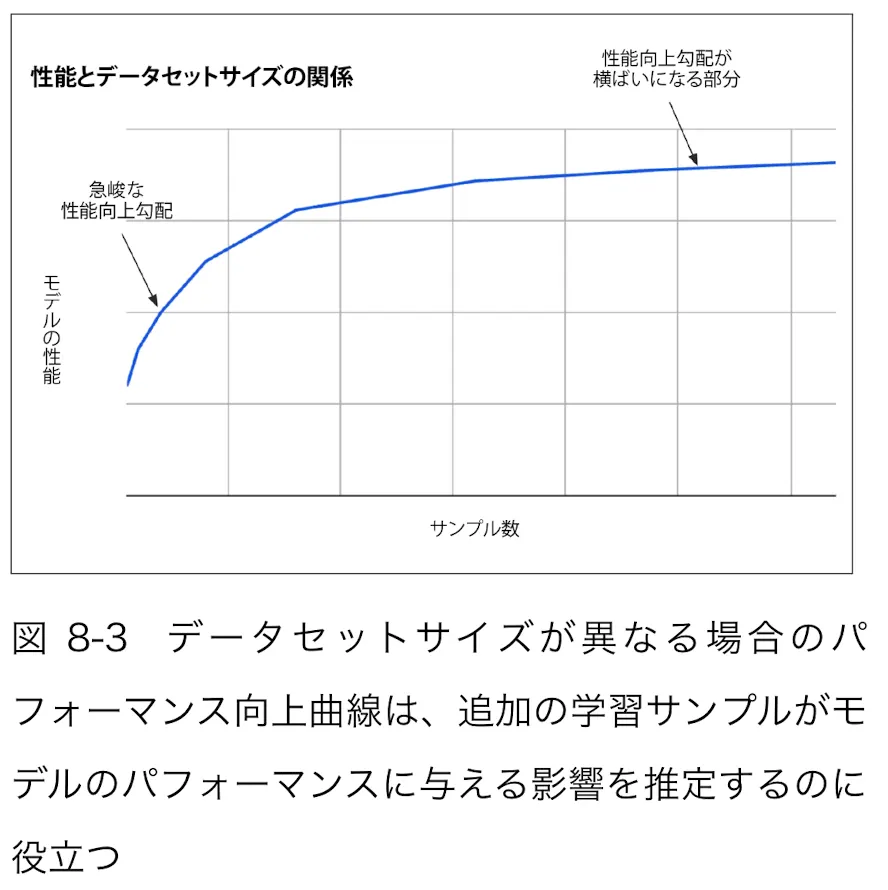
データ取得は、公開データのソーシング、専用データの購入、データのアノテーション、データの合成によるデータ収集が含まれる。
データフライホイール : 製品が使われる程データが生まれ、そのデータで製品が改善され、さらにユーザーが増えるという好循環の仕組み
アノテーションが難しいのは、明確なアノテーションガイドを作成することが複雑なため。
LinkedInはアノテーションガイドラインがAIエンジニアリングパイプラインの中で最も困難な部分の1つだったと述べている。
https://www.linkedin.com/blog/engineering/generative-ai/musings-on-building-a-generative-ai-product?_l=en_US
データ拡張とデータ合成
データ拡張 : 既存のデータから新しいデータを作成
データ合成 : 実データの特性を模倣するためにデータを生成
データ合成を行う意図
- データ量を増やすため
- データカバレッジを向上させるため
- データ品質を向上させるため : 人間が持つ根本的な限界のために、人間が生成したデータがAIが生成したデータよりも品質が低くなることがある
- プライバシーに関する懸念を緩和するため : プライバシーに関する懸念から人間が生成したデータを使用できないユースケースがある。
- モデルを蒸留するため
従来のデータ合成の技術
- ルールベースのデータ合成
- シミュレーション
企業は評価可能なアプリケーションを開発する傾向にあり、検証がしやすいデータを合成する傾向にある。
機能正確性で検証できない合成データは、AI as a Judgeで評価するのが一般的
AIが生成したデータの限界が生じる理由
- 品質管理 : AIが生成したデータは品質が低い可能性があり、人々が合成データの使用をためらうことになる
- 表面的な模倣 : 模倣モデルは事実の正確性や学習データ外のタスクへの汎化性能が低い。生徒モデルにハルシネーションを引き起こす可能性がある
- モデル崩壊の可能性 : モデルがどの程度の量のAI生成データを学習できるか不明瞭。AIが生成したデータを訓練中に再帰的に利用すると、パフォーマンスが低下する可能性がある。モデル崩壊と呼ぶ。
- 不明瞭なデータの出自 : ベースモデルが著作権侵害のあるデータで訓練されていた場合、ファインチューニングモデルも著作権を侵害する可能性がある
モデル崩壊が起きる理由は、AIモデルは確率の高いイベントを生成しやすいため、複数のイテレーションを経て、確率の低いイベントは過少に表現され、モデルは時間とともに一般的なイベントを出力するようになり、稀なイベントを忘れるため。
データ処理
データ検査で行うこと
- データの情報と統計の取得
- データがどこから来たか?どのように処理されたか?他に何に使用されたか?を確認
- トークンの分布、入力長、応答長などの分布をプロット
- データ内の特殊なトークンの有無
- データ内のトピックや言語の分布
データを重複排除するための方法
- ペアワイズ比較 : 完全一致、n-gramマッチ、ファジーマッチ、意味的類似性スコアマッチを用い、データセット内の各サンプル同志の類似性スコアを計算。
- ハッシュ化 : サンプルを異なるバケットにハッシュ化し、同じバケットに分類されたサンプルの間でのみチェックする
- 次元削減 : データを次元削減したのち、ペアワイズ比較する
Databricksによると無関係なMarkdown、HTMLトークンを削除することで、入力トークンの長さを60%削除しながら、モデル精度を20%向上できたと報告してる
https://www.databricks.com/blog/announcing-mlflow-28-llm-judge-metrics-and-best-practices-llm-evaluation-rag-applications-part
9章 推論の最適化
推論サーバー: モデルの推論を実行するコンポーネント。モデルをホストし、必要なハードウェアへのアクセスを可能にする。推論サービスの一部。
推論サービス : リクエストが推論サーバーに到達する前に、リクエストの受信、ルーティング、前処理を担当する
推論ワークロードの計算上の主なボトルネック
- コンピュートバウンド : タスクの完了までにかかる時間が、そのタスクに必要な計算量によって決まる状態
- メモリ帯域幅バウンド : タスクがメモリとプロセッサ間のデータ移動速度といった、システム内のデータ転送速度によって制約される状態
Stable Diffusionのような画像生成モデルの推論はコンピュートバウンド、自己回帰型言語モデルの推論はメモリ帯域幅バウンド
ワークロードが、コンピュートバウンドかメモリ帯域幅バウンドのどちらか判断するには、ルーフラインチャートを使う。
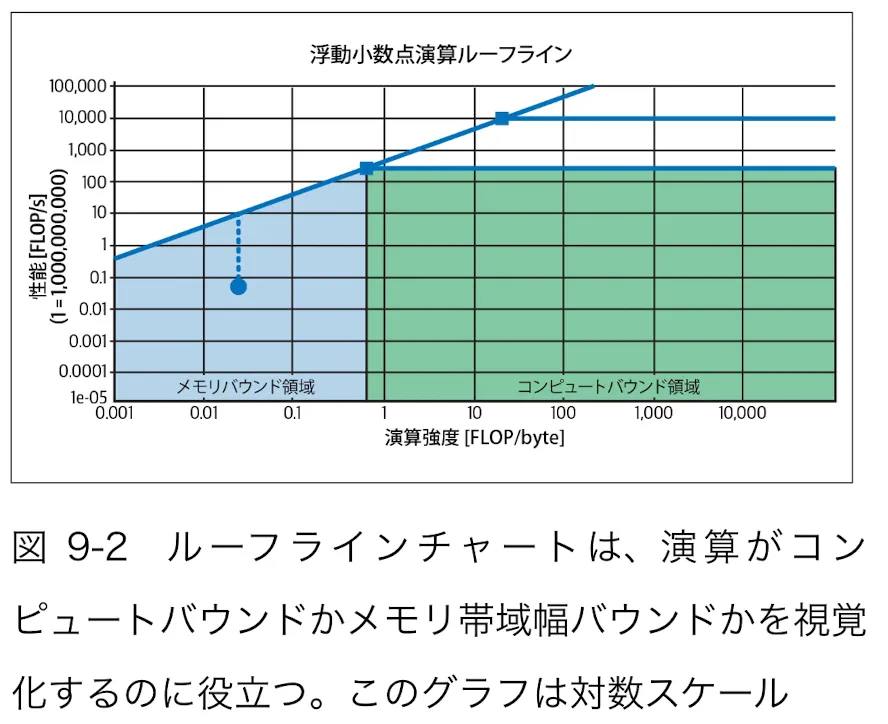
Transformerベースの言語モデルの推論ステップ構成
- プレフィル : モデルが入力トークンを並列処理。一度に処理できるトークン数は、ハードウェアが一定時間内に実行できる演算数で制限されるため、コンピュートバウンド
- デコード : 出力トークンを一度に1つずつ生成する。モデルを重み行列をGPUにロードするため、ハードウェアがメモリにデータをロードする時間に制限され、メモリ帯域幅バウンド
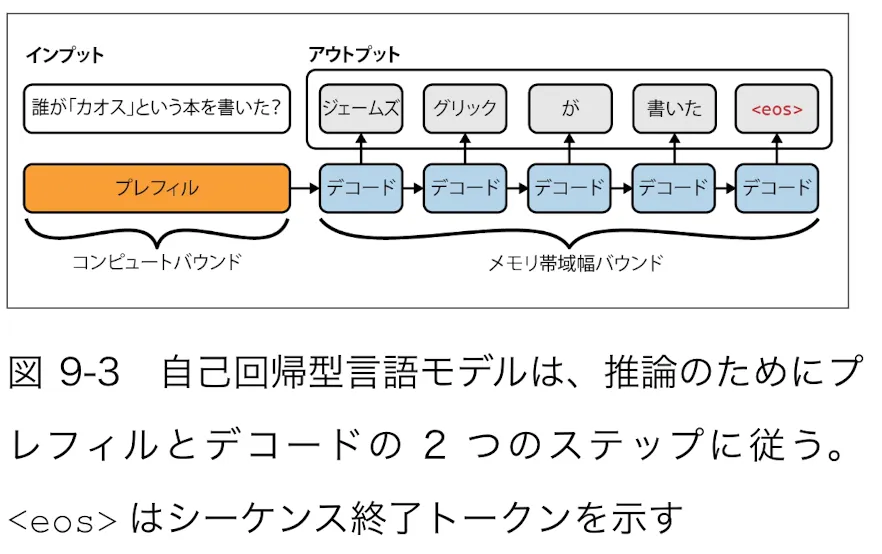
自己回帰デコーディングではモデルが応答を完了するまで時間がかかる場合があり、応答全体を一度に返すのはユーザーを待たせる。
多くのオンラインAPIはストリーミングモードを提供。
レイテンシーに関するメトリクス
- 最初のトークンまでの時間(TFTT) : ユーザーがクエリを送信してから最初のトークンが生成されるまでの速度を測る指標、プレフィルステップの所要時間に対応し、入力の長さに依存する。
- 出力トークンあたりの時間(TPOT Time per Output Token): 最初のトークンが生成された後、後続の各出力トークンがどれだけ早く生成されるかを測る指標
- トークン間の時間とトークン間レイテンシー
総レイテンシー=TTFT + TPOT * 出力トークン
一部のチームでは、ユーザーが目にする最初のトークンまでの時間を測っている。
グッドプット : SLOを満たした1秒あたりのリクエスト数
MFU(Model FLOP/s Utilization) : マシンが計算可能な全演算能力のうち、特定の時間内にどれだけの演算を実行しているか。システムの理論上の最大スループットに対する、実際のスループットの比率。
MBU(Model Bandwidth Utilization) : 達成可能な最大メモリ帯域幅のうち、実際に使用されている帯域幅の割合。
1970年代の最初の「AIの冬」が訪れた要因の一つが、十分に強力なコンピューターが不足していたこと。
NVIDIA H100をピーク性能で1年間稼働させると、約7000kWhを消費する。(米国の一般家庭の年間電力消費量は10000kWh)
推論の最適化
モデル圧縮 : モデルサイズを削減する技術。量子化、蒸留、プルーニングなど。
NNにおけるプルーニングの意味
- NNのノード全体を削除することでアーキテクチャを変更し、パラメータ数を削減すること
- 予測への貢献度が最も低いパラメータを見つけて、ゼロに設定すること
重みのみの量子化は、適用が容易、追加設定なしで利用可能であるため、最も広く用いられている。
モデルAPIプロバイダーが提供する出力トークンのコストは、入力トークンのコストの約2~4倍
自己回帰言語モデルの生成時間のボトルネックを克服するためのアプローチ
- 投機的デコーディング
- 参照を用いた推論
- 並列デコーディング
アテンション機構の仕組みそのものの変更や、カーネルとコンパイラという、モデル開発の細かい部分まで突っ込んだ話を取り上げている。
実務との関連付けがイメージできなかったのでスキップ。
推論サービスに関わるバッチ処理の手法
- 静的バッチ処理 : 固定数の入力を1つのバッチにまとめる。バッチが満たされるまで、全てのリクエストが実行をまたなければいけない。
- 動的バッチ処理 : 各バッチにタイムアウトを設定。バッチが満たされないまま処理されることがある。
- 連続バッチ処理 : バッチ内の各リクエストが完了次第、その応答をすぐにユーザーに返す。
LLMの推論は、コンピュートバウンドのプレフィルと、メモリ帯域幅バウンドのデコードの2つのステップで構成される。
プレフィルとデコードの分離が最適化手法として一般的。
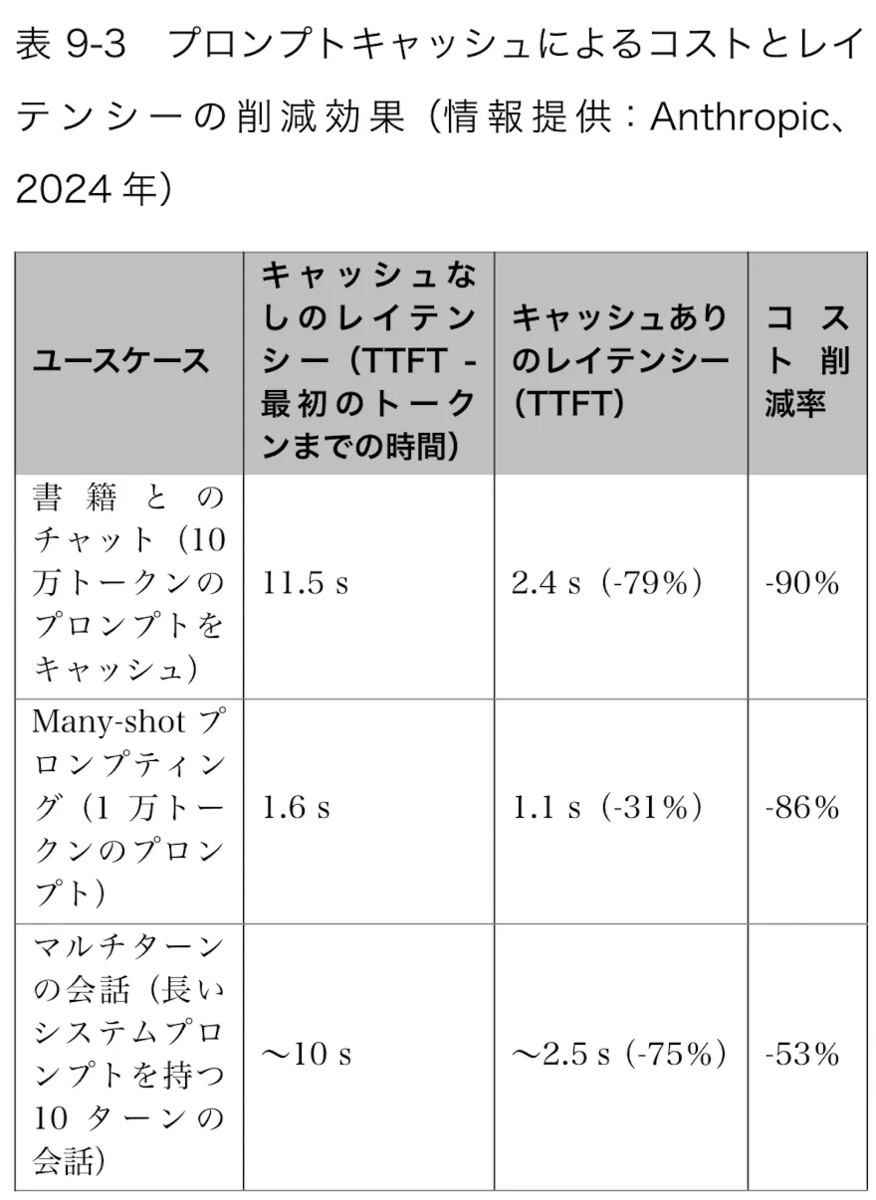
プロンプトキャッシュ : 重複するテキストセグメントを再利用できるように保存する仕組み。システムプロンプトが典型例。
多くのモデルAPIプロバイダーがプロンプトキャッシュの機能を提供してる。
10章 AIエンジニアリングのアーキテクチャとユーザーフィードバック
AIエンジニアリングアーキテクチャ
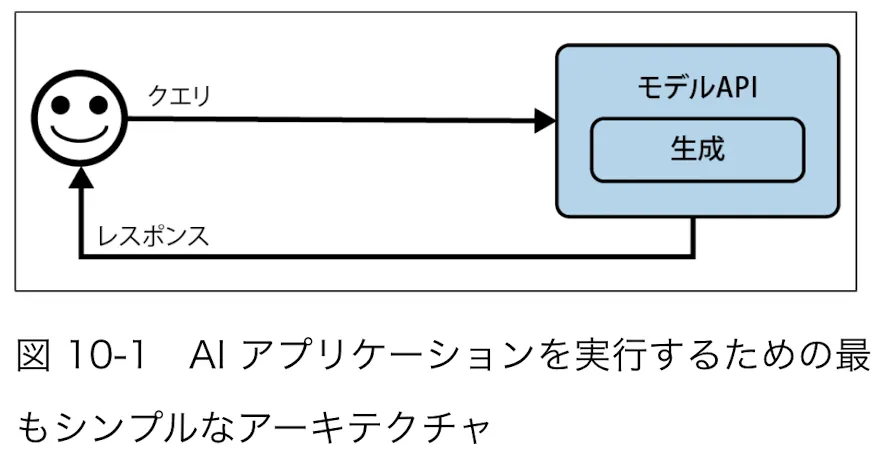
最もシンプルな構成は、モデルAPIにクエリを送信し、生成をユーザーにレスポンスするシステム。
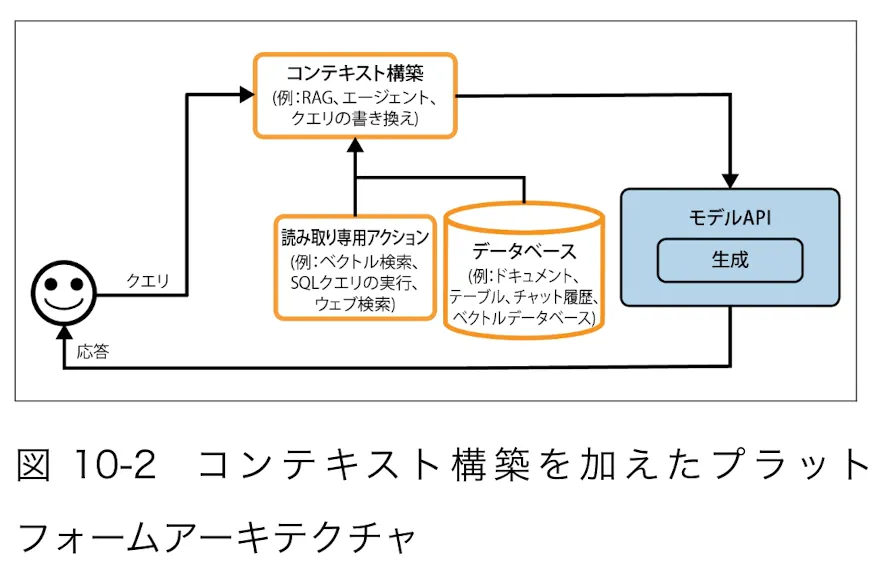
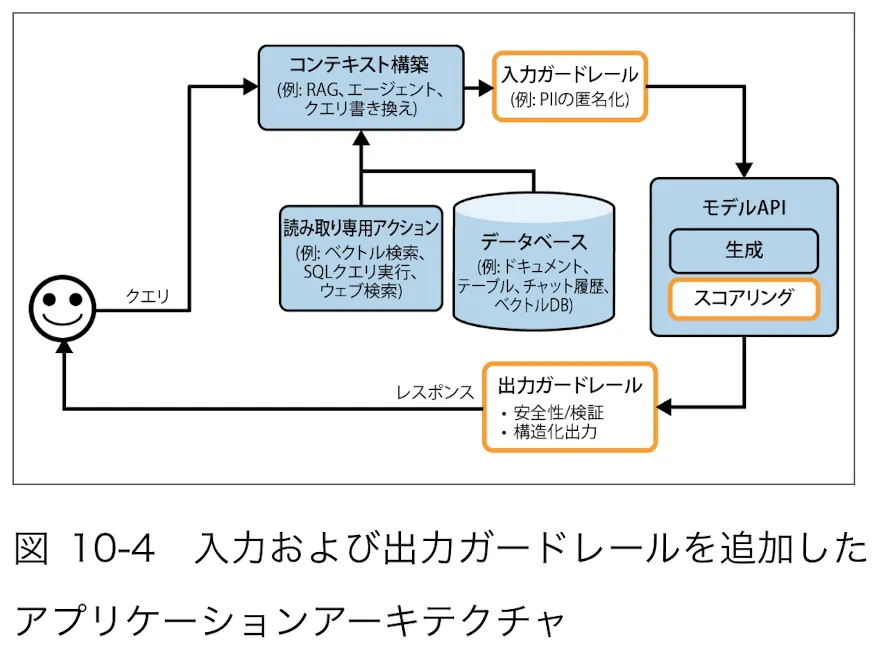
必要に応じて以下のコンポーネントを追加していく
- モデルが情報収集のために外部データソースやツールにアクセスできるようにする
- システムとユーザーを保護するためのガードレールを設置
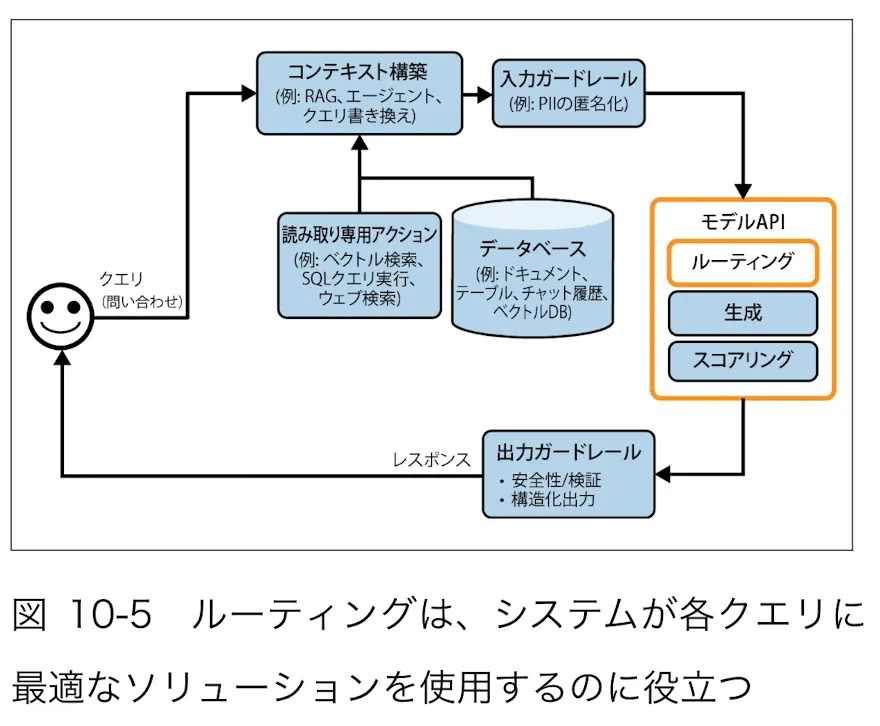
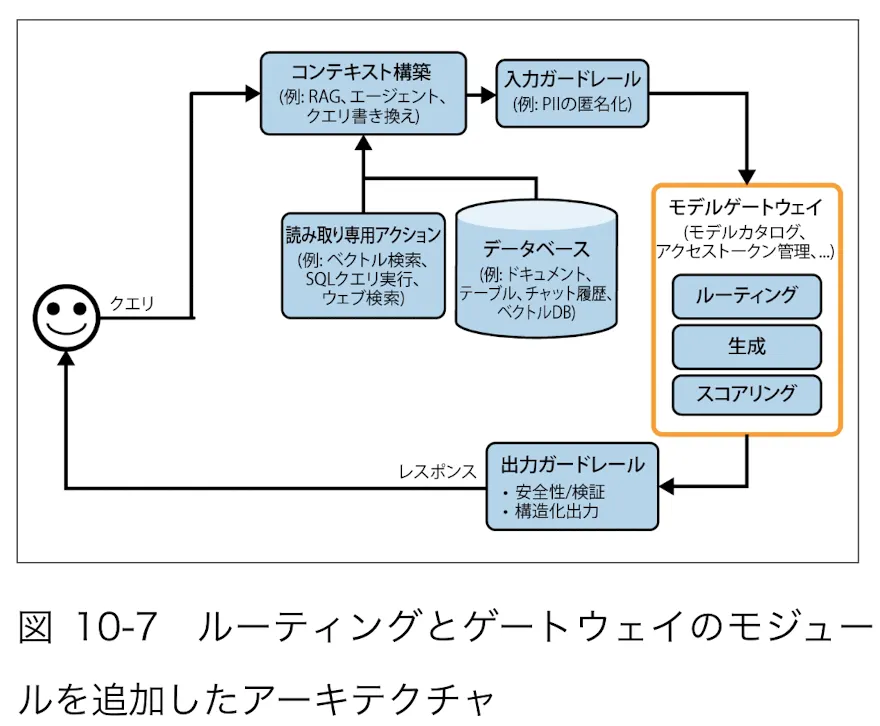
- モデルルーターとゲートウェイの追加
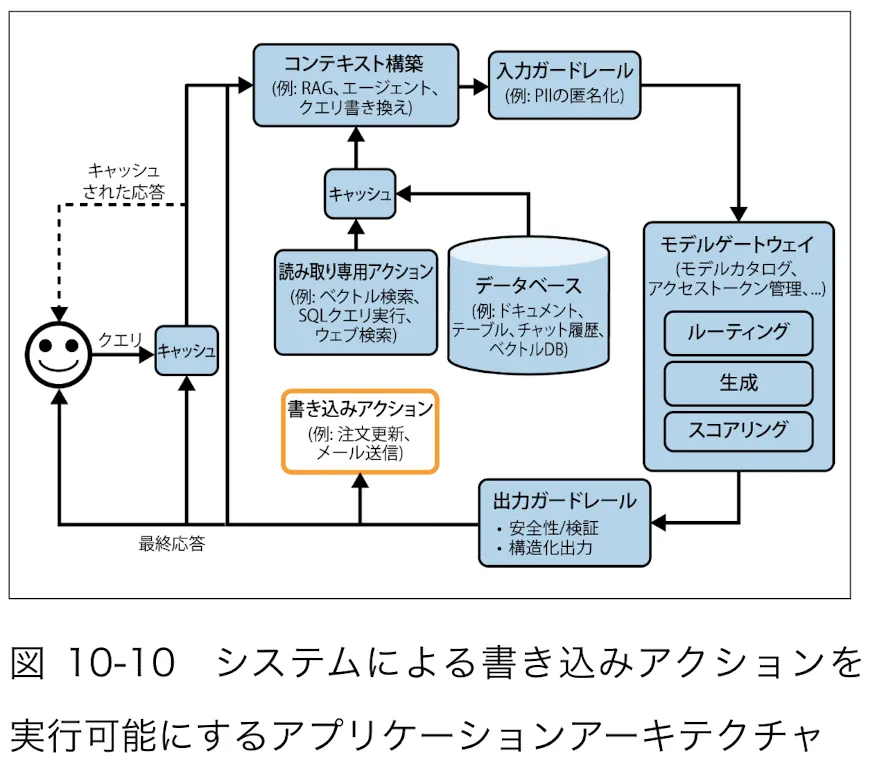
- キャッシュによってレイテンシーとコストを最適化
- 複雑なロジックと書き込みアクションを追加
プラットフォームを最初に拡張する際は、モデルがクエリの回答に必要なコンテキストをシステムが構築できる仕組みを追加する。
テキスト検索、画像検索、表形式データ検索。Web検索、ニュース、天気、イベントなどのAPIを通じ、モデルが自動的に情報を収集するツールを用いる。
Chip氏はコンテキスト構築は、基盤モデルにおける特徴量エンジニアリングのようなものと述べている。
入力ガードレールがシステムを保護する2つのリスク
- 外部APIへの個人情報の漏洩
- システムを危険にさらす悪意あるプロンプトの実行
一般的な機密データの分類
- 個人情報
- 人間の顔
- 会社の知的財産や特権情報に関連する特定のキーワードやフレーズ
多くの機密情報検出ツールは、AIを用いて秘密情報となりうる情報を特定する。
出力ガードレールの機能
- 出力の失敗を特定する
- 様々な失敗パターンに対応するための方針を定める
品質とセキュリティの一般的な失敗
- 品質: 期待される出力形式に従わない。ハルシネーションによる事実と矛盾する応答。一般的に質の悪い応答。
- セキュリティ : 人種差別、性的、有害な内容。外部ツールの呼び出しやコード実行を引き起こす応答。ブランドリスクのある応答。
多くの失敗は、単純にリトライすることで軽減できる。AIモデルは確率的であるため、同じクエリをリトライすると、異なる結果が得られる可能性がある。
クエリを同時に2回モデルに送信し、2つの応答を受け取ってより良い方を選択する方法がある。
クエリの種類ごとに異なるソリューションを用意する利点
- 特定のクエリに対して汎用モデルより優れたパフォーマンスを発揮する可能性がある
- 単純なクエリはより安価なモデルにルーティングでき、コスト節約になる
ルーターはユーザーの意図を予測するインデント分類機で構成される。
モデルゲートウェイはアクセス制御とコスト管理を提供する。
完全一致キャッシュ : キャッシュされたアイテムと全く同じアイテムがリクエストされた場合にキャッシュを使用する。
セマンティックキャッシュ : キャッシュされたアイテムが入力クエリと完全に同一でなくても、意味的に類似していれば利用される。
キャッシュは複数のステップ、時間のかかるアクションを伴うクエリで有効。
ユーザー固有のクエリや、時間的制約のあるクエリはキャッシュすべきではない。
キャッシュは適切に処理されないと、データ漏洩の可能性がある。
Chip氏は、セマンティックキャッシュの有効性に疑問を呈してる。
追跡可能な簡単なメトリクス
ログの一般原則は「すべてを記録する」こと。
モデルAPIのエンドポイント、モデル名、サンプリング設定、プロンプトテンプレート、ユーザークエリ、モデルに送信された最終プロンプト、出力、中間出力、ツール呼び出し、とその出力、コンポーネントの開始、終了、クラッシュ。
AIアプリケーションで起きる変化
- システムプロンプトの変更
- ユーザー行動の変化
- 基盤となるモデルの変更
AIアプリケーションのオーケストレーターの機能
ユーザーフィードバック
AIアプリケーションではユーザーフィードバックはプロプライエタリなデータであり、競争優位性の源泉となる。
ユーザーフィードバックは将来のモデル訓練にも使用できる。
自然言語フィードバック
- 早期終了
- エラー修正
- 苦情
- 感情
ユーザー行動からのフィードバック
- 再生成
- 会話の整理
- 会話の長さ
- 対話の多様性
行動の背景を理解するために、ユーザーを分析することが重要
Chip氏は会話の中で暗黙的な反応を抽出し、解釈して活用するアプローチが今後発展しくと予想している。
ユーザーフィードバックが価値を持つ場面
- 利用開始時
- 問題が発生した時
- モデルの確信度が低い時
Appleのヒューマンインターフェースガイドラインはポジティブとネガティブの両方のフィードバックを求めることに対して警告しているが、Chip氏はポジティブなフィードバックを送る選択肢があるべきだと考えている。
フィードバックはユーザーのワークフローにシームレスに統合されるべき
Midjourneyの優れたフィードバック例
- 生成画像を高解像度化
- 生成画像のバリエーションを生成
- 再生成
の選択肢を用意し、自然にユーザーフィードバックを集めてる。
コードアシスタントはユーザーがTabキーで提案を受け入れるか、拒否するか操作し、フィードバックできる。
ChatGPT、ClaudeのようなスタンドアロンAIアプリケーションの課題は、ユーザーの日常的なワークフローに統合されていないため、質の高いフィードバックを収集するのが難しい。
一部のプロダクトは、分析やプロダクト改善のためにユーザーデータにアクセスすることを許可する条項をサービス利用規約に盛り込んでいる。
ユーザーフィードバックを、パーソナライズに使うのか、利用状況に関する統計を収集するために使うのか、新しいモデルを訓練するために使うのか、目的をユーザーに明らかにする。
ユーザーがプライバシーを懸念してる場合は、データがモデルの学習に使われたり、デバイスから外部にでないことを保証する。
フィードバックバイアス
- 寛容性バイアス : 対象を実態よりも肯定的に評価してしまう傾向
- 位置バイアス : 選択肢がユーザーに提示される位置は、選択肢がどのように認識されるかに影響する。提案の位置をランダムに変えることでバイアスを軽減できる。
- 好みバイアス : 人は精度が低くてもより長い回答を好み、最後に見た回答を好む傾向がある
縮退フィードバックループ : 予測自体がフィードバックに影響を与え、それが次のモデルのイテレーションに影響を与え、初期のバイアスを増幅させること。
縮退フィードバックにより、生成コンテンツの偏りや、他のバイアスを増幅させる可能性がある。
ユーザーフィードバックに基づいて行動すると、会話エージェントが「嘘つき」になる可能性がある。
特徴量ストアを拡張した特徴量プラットフォームについて調べてみた
この記事はMLOps(LLMOps、生成AIOps、AI AgentOps) Advent Calendar 2025にリンクしてます。
本記事のまとめ
- 特徴量ストアを拡張した特徴量プラットフォームという概念が登場
- 特徴量ストアは特徴量プラットフォームの機能の一部という位置付け
- 特徴量プラットフォームは5つの要素で構成される
- 特徴量プラットフォームにおける特徴量ストアの目的は2つ
- 特徴量の保存:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を保存
- 特徴量の提供:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を提供
特徴量ストア
特徴量ストアの責務が曖昧になっている
特徴量ストアは2017年のUberのブログ記事で初めて登場して以降、MLOps実践のための機能の一つとして注目され、特徴量ストアという名前がつく様々なサービスが登場しています。
様々な特徴量ストアのサービスが、モニタリング機能やストリーミング処理機能などをサポートし、幅広いユーザー課題に応えてくれる存在になっています。
一方で各サービスの「特徴量ストア」が持つ機能が増え、特徴量ストアの責務が曖昧になっていると感じます。
特徴量ストア登場時の機能と、現在の機能を整理します。
2017年の登場時の機能
「特徴量ストア」という言葉は2017年に公開された、Uberが利用している機械学習プラットフォームのMichelangeloについてのブログ記事で初めて登場しました。
Meet Michelangelo: Uber's Machine Learning Platform | Uber Blog
このブログ記事内では、特徴量ストアを、「高品質にキュレーション※された特徴量のセットを共有、発見、使用できるようにするもの」と説明しています。
※キュレーション: 情報を収集・選択し、取りまとめて共有すること
特徴量ストアの導入背景にある課題として、Uber社内の様々な機械学習モデルの開発過程で、全く同じか似たような特徴量を使用していたことを指摘しています。このような状況から、Uberではプロジェクト間・チーム間で特徴量を共有できる仕組みを提供することで、大きな価値を生まれると述べています。
In addition, we added a layer of data management, a feature store that allows teams to share, discover, and use a highly curated set of features for their machine learning problems. We found that many modeling problems at Uber use identical or similar features, and there is substantial value in enabling teams to share features between their own projects and for teams in different organizations to share features with each other.
特徴量ストアを導入したことで、以下2つの成果があったと述べています。
- 個人やプロジェクト固有の用途で必要な情報に加え、わずかな追加メタデータを付与するだけで特徴量を簡単に特徴量ストアに追加できる
- モデル設定内の特徴量名を参照するだけで、特徴量ストアの特徴量をオンライン・オフラインで簡単に利用できる
下図は、Michelangeloを利用した機械学習プロジェクトのワークフロー全体の中での特徴量ストアの役割を表した図です。
オンライン・オフラインの特徴量ストアが存在します。オンラインではリアルタイム推論サービスへの特徴量の提供、オフラインではモデル学習やバッチ推論への特徴量の提供を行っています。

このように、特徴量ストアは、オンライン・オフラインでの特徴量の保存と提供によって、Uberの特徴量管理の課題を解決する存在でした。
現在の「特徴量ストア」サービスの機能
AWSでは、機械学習マネージドサービスである Amazon SageMaker の機能の一部として、Amazon SageMaker Feature Store が提供されています。
特徴量ストアを使用して特徴量を作成、保存、共有する - Amazon SageMaker AI
Amazon SageMaker Feature Storeでは以下の機能が含まれます。
- 特徴量グループ
- オンラインストア
- オフラインストア
- Data Wranglerと連携した、特徴量のクエリ、探索、可視化
- AWSサービスと連携した、ストリーミング・バッチデータ取り込み
- 特徴量計算
- 特徴量生成パイプラインの作成
- 耐障害性
- 複数AZに配置
オフライン・オンラインでの特徴量の保存と提供に加え、特徴量処理や、アクセス制御、データ取り込み機能などをAmazon SageMaker Feature Storeではサポートしています。
このように、2017年の登場時の特徴量ストアの機能と比較して、現在の特徴量ストアサービスの機能は拡大しています。
特徴量プラットフォーム
2023年にChip Huyen氏が公開したブログ記事「Self-serve feature platforms: architectures and APIs」で特徴量プラットフォームの概念が紹介されました。
Self-serve feature platforms: architectures and APIs
従来の特徴量ストアが特徴量の保存と提供を責務とする一方、特徴量プラットフォームは特徴量計算も責務に含めています。
特徴量プラットフォームの概念が出た背景として、機械学習の主なユースケースがバッチ推論からオンライン推論に移行したことを指摘しています。オンライン推論のための特徴量処理はレイテンシの問題があります。そのため、特徴量処理に最適化されたツールをモデル開発者に提供することは、大規模なオンライン推論にスケールさせるために必要であると述べています。
以下の図は特徴量プラットフォームを提供するTecton※のブログ記事から引用した、特徴量プラットフォームを説明する図です。
※ 2025年8月にDatabricksがTectonを買収したため、現在はDatabricksの機能の一部という表現が正確かもしれません。
What Is a Feature Platform for Machine Learning? | Databricks

特徴量プラットフォームは5つの要素で構成されます。
- 特徴量ロジック:SQL、PySpark、Pythonなどによる特徴量計算ロジックの記述
- 特徴量レポジトリ:Gitなどのレポジトリで特徴量定義をファイルとして管理
- 特徴量エンジン:バッチ・ストリーミング・リアルタイムデータの処理
- 特徴量ストア:オフライン・オンラインで一貫した特徴量を保存・提供
- 特徴量管理:エンドツーエンドの特徴量パイプラインの発見、使用、監視、ガバナンス
特徴量プラットフォームと特徴量ストアの関係
特徴量プラットフォームでは特徴量ストアは機能の一部という位置付けです。Tectonのブログ記事では、特徴量プラットフォームにおける特徴量ストアの目的は2つと述べられています。
- 特徴量の保存:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を保存
- 特徴量の提供:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を提供
現在の「特徴量ストア」の名前がつくサービスは、2017年登場時の特徴量ストアの概念を拡大させた、特徴量プラットフォームの機能をサポートしているものが多いです。
特徴量ストアと特徴量プラットフォームの背景にある課題感が異なるため、自分たちが抱える課題がどちらのツールを必要とするものか区別する必要があります。
余談: 特徴量ストア(プラットフォーム)は本当に必要か
自分たちの課題に対して、世の中の特徴量ストア(プラットフォーム)が必ずしもマッチしないことについて言及したブログ記事が面白かったので紹介します。
Building a feature store - nlathia.github.io
特徴量プラットフォームでは特徴量計算に関わる機能を一元管理します。特徴量プラットフォームを支持する人は2つの利点を強調すると述べています。
- 「同じものを2度構築する」無駄をなくせる
- 異なる問題領域間での再利用可能な特徴量の発見
この特徴量プラットフォーム支持者の考えに対して、懐疑的な意見を述べています。
「コードを一度だけ書く」は全てのユースケースに対して機能するわけではない
the “only code things once” pitch doesn’t actually work for all use cases.
データの一元管理を進めると、次第にそのデータが何を意味し、どのように使用すべきかという文脈が失われていく傾向がある。数千もの特徴量が存在するようになると、それらを一覧化した中央リストの管理は困難を極める。
At some point, centralising all of the data would come hand-in-hand with a loss of context about what that data means, and how it should be used. Once you have 1000s of features, a central list of them becomes difficult to navigate.
また、特徴量プラットフォームのサービスページを見ると、特徴量プラットフォームが解決できる5 ~ 10個の課題が列挙されていて、情報量に圧倒されると指摘しています。
ブログ記事内のチームでは、特徴量プラットフォームが既存システムの代替になったり、小規模なチームが巨大なシステムを管理する状態を避け、特徴量プラットフォームが解決する問題領域を絞り込んでいます。
I didn’t want the feature store to become a replacement for things that already existed, or a behemoth that is owned by my (small) team. Instead, I learned about what we needed by looking for patterns in the machine learning models that we were shipping.
まとめ
- 特徴量ストアを拡張した特徴量プラットフォームという概念が登場
- 特徴量ストアは特徴量プラットフォームの機能の一部という位置付け
- 特徴量プラットフォームは5つの要素で構成される
- 特徴量プラットフォームにおける特徴量ストアの目的は2つ
- 特徴量の保存:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を保存
- 特徴量の提供:オフライン学習環境とオンライン推論環境で一貫性のある特徴量を提供
『実践MLOps 作って理解する機械学習システムの構築と運用』という本を書きました

2025年10月18日に刊行される『実践MLOps 作って理解する機械学習システムの構築と運用』というMLOpsに関する本を執筆しました。
本の内容の紹介をさせていただきます。
執筆経緯
MLOpsを実践する場合、多くの問題はソフトウェアエンジニアリングに関する問題だと気づきます。
多くの企業では、MLOpsは機械学習エンジニアやデータサイエンティストが担当する場合が多いです。彼らは役割の性質上ソフトウェアエンジニアリング業務に関わる機会が限られるため、MLOpsの概念を実践するハードルが高いと言わざるを得ません。
2025年現在、MLOpsを体系的に説明した書籍が出版されるようになりました。しかし、MLOpsの概念的な内容の整理に留まり、具体的な実践方法まで踏み込んでいる書籍はまだまだ少ない印象です。
このようなMLOpsの概念的な理解と、実際にMLOpsを実践する際に求められるソフトウェアエンジニアリングスキルとのギャップを埋められるよう、本書を執筆しました。
どんな本か
本書では、広告クリック率予測を行う機械学習システムを、AWSで構築・運用する一連の流れを通して、MLOpsを実践的に学ぶ一冊です。
本書の特徴は機械学習システムの運用にまでカバーしている点です。
本書は準備・開発・運用の3つのカテゴリの目次構成となっています。準備・開発のカテゴリでは、一般的なMLOpsの説明を行った後、機械学習パイプラインの実装を行います。運用のカテゴリではバージョン管理、CI・CD、推論サービス、継続的学習、監視のトピックをカバーします。

本書ではMLOpsを「DevOpsを機械学習システムに適用した手法」と位置付けています。そのため、TerraformによるIaC (Infrastructure as Code)や、GitHub ActionsによるCI・CDのような、一般的なソフトウェア開発で扱う技術トピックが多く含まれます。
また、本書ではMLOpsを機械学習の専門家のみが扱う領域とせず、一般的なソフトウェア開発に準拠した技術選定の方針をとっています。そのため、本書では機械学習のマネージドサービスを使わずに、従来のソフトウェア開発で一般的に使用されるAWSサービスを使用します。例えば、推論サービスにはECS (Elastic Cotainer Service)を使用し、特徴量ストアやモデルレジストリのようなMLOps特有の要素をDynamoDBを使用して構築します。
本書はソフトウェア開発の初学者向けの本ではありません。本書は264ページという限られたページ数の中で、機械学習システムの開発から運用までを行うため、機械学習やAWSの基礎的な説明は省略しています。また、MLOpsの要素として一般的に含まれる組織作りやチーム体制などの非技術的な側面は扱いません。
より広くMLOpsを学びたい方は、『事例でわかるMLOps』や『機械学習システムデザイン』が参考になると思います。本書はこれらの本に書かれている内容の、一つの例を実践するような立ち位置となります。
本書で利用するコードをGitHubリポジトリで公開しています。 github.com
本の内容イメージ
本書は、筆者が前職で講師を行なったMLOps研修の経験が生かされています。
そのため、本書の内容はこれらの資料をより深く掘り下げたものとイメージしてもらえると分かりやすいです。
ALBとNLBの違いを実際に作って理解する
本記事のコードです。
github.com
ALB, NLBの説明の具体的なイメージがわかない
AWSのロードバランサーを作成する場合、ALB (Application Load Balancer)かNLB (Network Load Balancer)のどちらかを選択します。
※ Gateway Load BalancerやClassic Load Balancerも提供されていますが、ユースーケースが限定的なため本記事では扱いません。
以下はAWSマネジメントコンソールのロードバランサー作成画面での、各サービスの説明文です。

ALBとNLBの違いについて説明した文章を読むと、ALBはアプリケーション層(7層. HTTP/HTTPS)、NLBはトランスポート層(4層. TCP/UDP)でトラフィック分割を行うという表現を見ることが多いです。
特徴 - Elastic Load Balancing | AWS

自分はこの説明を見るたびに、具体的な動作の違いをイメージできておらず、納得感を得られてなかったです。
以下はAWSマネジメントコンソールの、ALBの説明文です。
HTTP および HTTPS トラフィックを使用するウェブアプリケーション用に柔軟性の高い機能セットが必要な場合は、Application Load Balancer を選択します
自分はこの文章を読んだ時
という疑問が起きました。
本記事では、ALBとNLBを実際に作成して、その動作の違いを確認し、ALB・NLBの説明の具体的なイメージを掴もうと思います。
本記事で作成する構成

ALB・NLBのトラフィックをECS Serviceに割り当てます。
ALBとNLBをパブリックサブネットに起動し、インターネット経由でローカルPCからリクエストを送信します。
AWSリソースのデプロイ
ネットワーク
以下は、本記事のシステムで使用するネットワークを作成するTerraformです。
ALBは2つ以上のサブネットに作成する必要があるため、2つのAZにパブリックサブネットを作成します。
Application Load Balancer - エラスティックロードバランシング
静的IPをNLBに付与するために、Elastic IPを用意しています。
# VPC
resource "aws_vpc" "alb_nlb" {
  cidr_block           = "10.0.0.0/16"
  enable_dns_hostnames = true
  enable_dns_support   = true
}

# Internet Gateway
resource "aws_internet_gateway" "alb_nlb" {
  vpc_id = aws_vpc.alb_nlb.id
}

data "aws_availability_zones" "available" {
  state = "available"
}

# Public Subnets
resource "aws_subnet" "public_1" {
  vpc_id                  = aws_vpc.alb_nlb.id
  cidr_block              = "10.0.1.0/24"
  availability_zone       = data.aws_availability_zones.available.names[0]
  map_public_ip_on_launch = true

}

resource "aws_subnet" "public_2" {
  vpc_id                  = aws_vpc.alb_nlb.id
  cidr_block              = "10.0.2.0/24"
  availability_zone       = data.aws_availability_zones.available.names[1]
  map_public_ip_on_launch = true

}

resource "aws_route_table" "public" {
  vpc_id = aws_vpc.alb_nlb.id

  route {
    cidr_block = "0.0.0.0/0"
    gateway_id = aws_internet_gateway.alb_nlb.id
  }
}

resource "aws_route_table_association" "public_1" {
  subnet_id      = aws_subnet.public_1.id
  route_table_id = aws_route_table.public.id
}

resource "aws_route_table_association" "public_2" {
  subnet_id      = aws_subnet.public_2.id
  route_table_id = aws_route_table.public.id
}

# Elastic IP
resource "aws_eip" "nlb_1" {
  domain = "vpc"
}

resource "aws_eip" "nlb_2" {
  domain = "vpc"
}
ALB, NLB, ECS Serviceのセキュリティグループを作成するTerraformコードです。
2023年以前はALBのみしかセキュリティグループを設定できませんが、現在はNLBにもセキュリティグループを設定できるようです。
Network Load Balancer のセキュリティグループを更新する - エラスティックロードバランシング
# Security Group
resource "aws_security_group" "alb" {
  name        = "alb-sg"
  description = "Security group for ALB"
  vpc_id      = aws_vpc.alb_nlb.id

  ingress {
    from_port   = 80
    to_port     = 80
    protocol    = "tcp"
    cidr_blocks = ["0.0.0.0/0"]
  }

  egress {
    from_port   = 0
    to_port     = 0
    protocol    = "-1"
    cidr_blocks = ["0.0.0.0/0"]
  }
}

resource "aws_security_group" "nlb" {
  name        = "nlb-sg"
  description = "Security group for NLB"
  vpc_id      = aws_vpc.alb_nlb.id

  ingress {
    from_port   = 80
    to_port     = 80
    protocol    = "tcp"
    cidr_blocks = ["0.0.0.0/0"]
  }

  egress {
    from_port   = 0
    to_port     = 0
    protocol    = "-1"
    cidr_blocks = ["0.0.0.0/0"]
  }
}

resource "aws_security_group" "alb_ecs" {
  name        = "alb-ecs-sg"
  description = "Security group for ECS tasks behind ALB"
  vpc_id      = aws_vpc.alb_nlb.id

  ingress {
    from_port       = 8080
    to_port         = 8080
    protocol        = "tcp"
    security_groups = [aws_security_group.alb.id]
  }

  egress {
    from_port   = 0
    to_port     = 0
    protocol    = "-1"
    cidr_blocks = ["0.0.0.0/0"]
  }
}

resource "aws_security_group" "nlb_ecs" {
  name        = "nlb-ecs-sg"
  description = "Security group for ECS tasks behind NLB"
  vpc_id      = aws_vpc.alb_nlb.id

  ingress {
    from_port       = 8080
    to_port         = 8080
    protocol        = "tcp"
    security_groups = [aws_security_group.nlb.id]
  }

  egress {
    from_port   = 0
    to_port     = 0
    protocol    = "-1"
    cidr_blocks = ["0.0.0.0/0"]
  }
}
ECSリソース
ECS Serviceを起動するための、ECSクラスター、ECS Task実行ロール、CloudWatchグループを作成する Terraformです。
resource "aws_ecs_cluster" "alb_nlb" {
  name = "alb-nlb-cluster"

  setting {
    name  = "containerInsights"
    value = "enabled"
  }
}

resource "aws_iam_role" "ecs_task_execution" {
  name = "ecs-task-execution"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Action = "sts:AssumeRole"
        Effect = "Allow"
        Principal = {
          Service = "ecs-tasks.amazonaws.com"
        }
      }
    ]
  })
}

resource "aws_iam_role_policy_attachment" "ecs_task_execution" {
  role       = aws_iam_role.ecs_task_execution.name
  policy_arn = "arn:aws:iam::aws:policy/service-role/AmazonECSTaskExecutionRolePolicy"
}

resource "aws_cloudwatch_log_group" "ecs" {
  name              = "/ecs/alb-nlb"
  retention_in_days = 3
}
ALB
ALBがトラフィックを割り当てるECSサービスを作成する Terraformコードです。
Hashicorpが提供するhashicorp/http-echo イメージを使用し、簡易的なHTTPレスポンスを返すアプリケーションを作成します。
GitHub - hashicorp/http-echo: A tiny go web server that echos what you start it with!
ALBのパスルーティングの挙動を確認するために、 alb-app と alb-api という2つのECSサービスを作成しています。
resource "aws_ecs_task_definition" "alb_app" {
  family                   = "alb-app"
  network_mode             = "awsvpc"
  requires_compatibilities = ["FARGATE"]
  cpu                      = "256"
  memory                   = "512"
  execution_role_arn       = aws_iam_role.ecs_task_execution.arn

  container_definitions = jsonencode([
    {
      name  = "app"
      image = "hashicorp/http-echo:latest"

      portMappings = [
        {
          containerPort = 8080
          protocol      = "tcp"
        }
      ]

      command = [
        "-text=ALB-APP-SERVICE: Successful response from ALB",
        "-listen=:8080"
      ]

      logConfiguration = {
        logDriver = "awslogs"
        options = {
          "awslogs-group"         = aws_cloudwatch_log_group.ecs.name
          "awslogs-region"        = local.aws_region
          "awslogs-stream-prefix" = "alb-app"
        }
      }
    }
  ])
}

resource "aws_ecs_task_definition" "alb_api" {
  family                   = "alb-api"
  network_mode             = "awsvpc"
  requires_compatibilities = ["FARGATE"]
  cpu                      = "256"
  memory                   = "512"
  execution_role_arn       = aws_iam_role.ecs_task_execution.arn

  container_definitions = jsonencode([
    {
      name  = "api"
      image = "hashicorp/http-echo:latest"

      portMappings = [
        {
          containerPort = 8080
          protocol      = "tcp"
        }
      ]

      command = [
        "-text=ALB-API-SERVICE: Successful response from ALB",
        "-listen=:8080"
      ]

      logConfiguration = {
        logDriver = "awslogs"
        options = {
          "awslogs-group"         = aws_cloudwatch_log_group.ecs.name
          "awslogs-region"        = local.aws_region
          "awslogs-stream-prefix" = "alb-api"
        }
      }
    }
  ])
}

resource "aws_ecs_service" "alb_app" {
  name            = "alb-app"
  cluster         = aws_ecs_cluster.alb_nlb.id
  task_definition = aws_ecs_task_definition.alb_app.arn
  desired_count   = 2
  launch_type     = "FARGATE"

  network_configuration {
    subnets          = [aws_subnet.public_1.id, aws_subnet.public_2.id]
    security_groups  = [aws_security_group.alb_ecs.id]
    assign_public_ip = true
  }

  load_balancer {
    target_group_arn = aws_lb_target_group.alb_app.arn
    container_name   = "app"
    container_port   = 8080
  }

  depends_on = [aws_lb_listener.alb_http]
}

resource "aws_ecs_service" "alb_api" {
  name            = "alb-api"
  cluster         = aws_ecs_cluster.alb_nlb.id
  task_definition = aws_ecs_task_definition.alb_api.arn
  desired_count   = 2
  launch_type     = "FARGATE"

  network_configuration {
    subnets          = [aws_subnet.public_1.id, aws_subnet.public_2.id]
    security_groups  = [aws_security_group.alb_ecs.id]
    assign_public_ip = true
  }

  load_balancer {
    target_group_arn = aws_lb_target_group.alb_api.arn
    container_name   = "api"
    container_port   = 8080
  }

  depends_on = [aws_lb_listener.alb_http]
}
以下はALBを作成するTerraformコードです。
リスナールールにパスパターンを設定しています。デフォルトのトラフィック送信先は alb-app-tg ターゲットグループですが、/apiパスへのリクエストの場合、 alb-api-tg ターゲットグループとします。
また、リダイレクトと固定レスポンスの設定を行なっています。
resource "aws_lb" "alb" {
  name               = "alb-app"
  internal           = false
  load_balancer_type = "application"
  security_groups    = [aws_security_group.alb.id]
  subnets            = [aws_subnet.public_1.id, aws_subnet.public_2.id]

  enable_deletion_protection = false
  enable_http2               = true

}

resource "aws_lb_target_group" "alb_app" {
  name        = "alb-app-tg"
  port        = 8080
  protocol    = "HTTP"
  vpc_id      = aws_vpc.alb_nlb.id
  target_type = "ip"

  health_check {
    enabled             = true
    healthy_threshold   = 2
    unhealthy_threshold = 2
    timeout             = 5
    interval            = 30
    path                = "/"
  }
}

resource "aws_lb_target_group" "alb_api" {
  name        = "alb-api-tg"
  port        = 8080
  protocol    = "HTTP"
  vpc_id      = aws_vpc.alb_nlb.id
  target_type = "ip"

  health_check {
    enabled             = true
    healthy_threshold   = 2
    unhealthy_threshold = 2
    timeout             = 5
    interval            = 30
    path                = "/"
  }
}

resource "aws_lb_listener" "alb_http" {
  load_balancer_arn = aws_lb.alb.arn
  port              = "80"
  protocol          = "HTTP"

  default_action {
    type             = "forward"
    target_group_arn = aws_lb_target_group.alb_app.arn
  }
}

resource "aws_lb_listener_rule" "alb_api_path" {
  listener_arn = aws_lb_listener.alb_http.arn
  priority     = 100

  action {
    type             = "forward"
    target_group_arn = aws_lb_target_group.alb_api.arn
  }

  condition {
    path_pattern {
      values = ["/api/*"]
    }
  }
}

resource "aws_lb_listener_rule" "redirect_api" {
  listener_arn = aws_lb_listener.alb_http.arn
  priority     = 90

  action {
    type = "redirect"
    redirect {
      path        = "/api"
      status_code = "HTTP_301"
    }
  }

  condition {
    path_pattern {
      values = ["/redirect/*", "/redirect"]
    }
  }
}

resource "aws_lb_listener_rule" "forbidden" {
  listener_arn = aws_lb_listener.alb_http.arn
  priority     = 10

  action {
    type = "fixed-response"
    fixed_response {
      content_type = "text/plain"
      message_body = "Access Denied: This resource is restricted"
      status_code  = "403"
    }
  }

  condition {
    path_pattern {
      values = ["/admin", "/admin/*"]
    }
  }
}
NLB
NLBがトラフィックを割り当てるECSサービスを作成する Terraformコードです。
istio/tcp-echo-server Dockerイメージを使用し、TCPトラフィックを処理するアプリケーションを起動します。
istio/samples/tcp-echo at release-1.1 · istio/istio · GitHub
resource "aws_ecs_service" "nlb_app" {
  name            = "nlb-app"
  cluster         = aws_ecs_cluster.alb_nlb.id
  task_definition = aws_ecs_task_definition.nlb_app.arn
  desired_count   = 2
  launch_type     = "FARGATE"

  network_configuration {
    subnets          = [aws_subnet.public_1.id, aws_subnet.public_2.id]
    security_groups  = [aws_security_group.nlb_ecs.id]
    assign_public_ip = true
  }

  load_balancer {
    target_group_arn = aws_lb_target_group.nlb_tcp.arn
    container_name   = "nlb-app"
    container_port   = 8080
  }

  depends_on = [aws_lb_listener.nlb_tcp]
}

resource "aws_ecs_task_definition" "nlb_app" {
  family                   = "nlb-app"
  network_mode             = "awsvpc"
  requires_compatibilities = ["FARGATE"]
  cpu                      = "256"
  memory                   = "512"
  execution_role_arn       = aws_iam_role.ecs_task_execution.arn

  container_definitions = jsonencode([
    {
      name  = "nlb-app"
      image = "istio/tcp-echo-server:latest"

      portMappings = [
        {
          containerPort = 8080
          protocol      = "tcp"
        }
      ]

      command = ["8080", "NLB-APP-SERVICE: Successful response from NLB"]

      logConfiguration = {
        logDriver = "awslogs"
        options = {
          "awslogs-group"         = aws_cloudwatch_log_group.ecs.name
          "awslogs-region"        = local.aws_region
          "awslogs-stream-prefix" = "nlb-app"
        }
      }
    }
  ])
}
以下はNLBを作成するTerraformコードです。
静的IPを設定しています。
resource "aws_lb" "nlb" {
  name               = "nlb"
  internal           = false
  load_balancer_type = "network"
  security_groups    = [aws_security_group.nlb.id]

  subnet_mapping {
    subnet_id     = aws_subnet.public_1.id
    allocation_id = aws_eip.nlb_1.id
  }

  subnet_mapping {
    subnet_id     = aws_subnet.public_2.id
    allocation_id = aws_eip.nlb_2.id
  }

  enable_deletion_protection       = false
  enable_cross_zone_load_balancing = false
}

resource "aws_lb_target_group" "nlb_tcp" {
  name        = "nlb-tcp-tg"
  port        = 8080
  protocol    = "TCP"
  vpc_id      = aws_vpc.alb_nlb.id
  target_type = "ip"

  health_check {
    enabled             = true
    healthy_threshold   = 2
    unhealthy_threshold = 2
    protocol            = "TCP"
  }

  preserve_client_ip = true
}

resource "aws_lb_listener" "nlb_tcp" {
  load_balancer_arn = aws_lb.nlb.arn
  port              = "80"
  protocol          = "TCP"

  default_action {
    type             = "forward"
    target_group_arn = aws_lb_target_group.nlb_tcp.arn
  }
}
検証
レイヤー7とレイヤー4のトラフィック分割の違い
ALBとNLBのトラフィック分割は以下となります。
アプリケーション層、ネットワーク層はOSI参照モデルのレイヤー名です。各レイヤーを担うプロトコルがあり、アプリケーション層はHTTP、トランスポート層はTCPやUDPが担います。
ALBとNLBではトラフィック分割で使用するプロトコルが異なることになります。

引用: OSI参照モデルとTCP/IPの階層の違いとは? 【2分間Q&A(1)】|ビジネス+IT
今回作成したALBはHTTP、NLBはTCPによるリクエストを受け付けます。
HTTPとTCPによるトラフィック分割の違いを確認します。
ALBのDNSに対してHTTPリクエストを送ります。正常にレスポンスが返ってくることを確認できます。
$ (echo -e "GET / HTTP/1.1\r\nHost: test\r\n\r\n"; cat) | nc -v alb-app-1499646873.ap-northeast-1.elb.amazonaws.com 80
Connection to alb-app-1499646873.ap-northeast-1.elb.amazonaws.com port 80 [tcp/http] succeeded!
HTTP/1.1 200 OK
Date: Wed, 01 Oct 2025 00:56:32 GMT
Content-Type: text/plain; charset=utf-8
Content-Length: 46
Connection: keep-alive
X-App-Name: http-echo
X-App-Version: 1.0.0

ALB-APP-SERVICE: Successful response from ALB
次に、無効なHTTPリクエストをALBに送信します。HTTP/1.1ではHostヘッダが必須なため、ALBが400エラーを返します。
とほほのHTTP入門 - とほほのWWW入門
ALBがHTTPリクエストメッセージを見ていることが分かります。
$ (echo -e "GET / HTTP/1.1\r\n\r\n"; cat) | nc -v alb-app-1499646873.ap-northeast-1.elb.amazonaws.com 80
Connection to alb-app-1499646873.ap-northeast-1.elb.amazonaws.com port 80 [tcp/http] succeeded!
HTTP/1.1 400 Bad Request
Server: awselb/2.0
Date: Wed, 01 Oct 2025 00:58:32 GMT
Content-Type: text/html
Content-Length: 122
Connection: close

<html>
<head><title>400 Bad Request</title></head>
<body>
<center><h1>400 Bad Request</h1></center>
</body>
</html>
次に、無効なHTTPリクエストをNLBに送信します。すると、正常なレスポンスが返ってくることを確認できます。
これは、NLBがHTTPリクエストメッセージを見ず、TCPヘッダーを見てトライフィックをECSに送信してるためです。
$ (echo -e "GET / HTTP/1.1\r\n\r\n"; cat) | nc -v nlb-ebdf9de1dbb1a350.elb.ap-northeast-1.amazonaws.com 80
Connection to nlb-ebdf9de1dbb1a350.elb.ap-northeast-1.amazonaws.com port 80 [tcp/http] succeeded!
NLB-APP-SERVICE: Successful response from NLB
上記の挙動の違いから、ALBとNLBのトラフィック分割で使用するプロトコルが違うことを実際に確認できました。
ALBの「柔軟性」を確認する
AWSマネージメントコンソールのALBの説明を再掲します。
HTTP および HTTPS トラフィックを使用するウェブアプリケーション用に柔軟性の高い機能セットが必要な場合は、Application Load Balancer を選択します
ALBはHTTPトラフィックを使用することを確認できました。次は、「柔軟性の高い機能セット」の部分を確認します。
以下は、ロードバランサーの機能比較を表した表です。ALBはHTTP/HTTPSプロトコルを活用した特徴がサポートされています。

ALBのリソースマップから、リスナールールを確認します。
Terraformで作成したパスルーティング、リダイレクト、固定レスポンスのリスナールールを確認できます。
これらのリスナールールの挙動を確認し、ALBの「柔軟性」を確認します。

パスルーティングの挙動を確認します。
/api パスにリクエストを送信すると、alb-apiのECSサービスからのレスポンスが返ってくるのを確認できます。
$ curl alb-app-1499646873.ap-northeast-1.elb.amazonaws.com/api
ALB-API-SERVICE: Successful response from ALB
リダイレクトの挙動を確認します。
/redirectパスにリクエストを送信すると、/api パスにリダイレクトされ、alb-apiのECSサービスのレスポンスが返ってくるのを確認できます。
$ curl -L alb-app-1499646873.ap-northeast-1.elb.amazonaws.com/redirect
ALB-API-SERVICE: Successful response from ALB
固定レスポンスの挙動を確認します。
/adminパスにリクエストを送信すると、ALBで設定した固定レスポンスが返ってくることを確認できます。
$ curl alb-app-1499646873.ap-northeast-1.elb.amazonaws.com/admin
Access Denied: This resource is restricted
HTTPリクエストを用いたトラフィック分散を行う性質から、ALBでは様々なトラフィック処理を行えることが分かりました。
NLBではこのようなHTTPリクエストをもとにした処理を行うことができないため、トラフィック処理の観点で、確かにALBはNLBより「柔軟性」があると言えそうです。
ALBとNLBのレイテンシの違いを確認する
AWSマネージメントコンソールのNLBの説明に以下の文章が含まれます。
Network Load Balancer は接続レベルで動作し、非常に低いレイテンシーを維持しながら、1 秒あたり数百万のリクエストを確実に処理することができます。
NLBはALBと比較した際に、低レイテンシーという特徴が挙げられることが多いです。
NLBがALBより低レイテンシーとなるか実際に確認します。
ALBとNLBでアプリケーションの処理を揃えるために、ALBと同様の処理を行うECSサービスにNLBのトラフィックを送信するように変更します。
以下は、起動イメージを変更したECS Task定義のTerraformコードです。
resource "aws_ecs_task_definition" "nlb_app" {
  family                   = "nlb-app"
  network_mode             = "awsvpc"
  requires_compatibilities = ["FARGATE"]
  cpu                      = "256"
  memory                   = "512"
  execution_role_arn       = aws_iam_role.ecs_task_execution.arn

  container_definitions = jsonencode([
    {
      name  = "nlb-app"
      image = "hashicorp/http-echo:latest"

      portMappings = [
        {
          containerPort = 8080
          protocol      = "tcp"
        }
      ]

      command = [
        "-text=NLB-APP-SERVICE: Successful response from NLB",
        "-listen=:8080"
      ]

      logConfiguration = {
        logDriver = "awslogs"
        options = {
          "awslogs-group"         = aws_cloudwatch_log_group.ecs.name
          "awslogs-region"        = local.aws_region
          "awslogs-stream-prefix" = "nlb-app"
        }
      }
    }
  ])
}
負荷試験ツールlocustを使ってALBとNLBのレイテンシを計測します。
Locust - A modern load testing framework
ALB・NLBを起動しているパブリックサブネットにEC2インスタンスを起動し、ALB・NLBにリクエストを送信します。
以下のスクリプトをEC2で実行し、統計結果ファイルを集計します。
import gevent
from locust import HttpUser, task
from locust.env import Environment
from locust.stats import StatsCSVFileWriter

class ELBUser(HttpUser):
    host = "http://alb-app-1499646873.ap-northeast-1.elb.amazonaws.com"

    @task
    def test_request(self):
        self.client.get("/test")

env: Environment = Environment(user_classes=[ELBUser])

csv_writer: StatsCSVFileWriter = StatsCSVFileWriter(
    environment=env,
    base_filepath="./alb",
    full_history=True,
    percentiles_to_report=[0.0, 100.0],
)
gevent.spawn(csv_writer)

env.create_local_runner()
env.runner.start(1, spawn_rate=1)

gevent.spawn_later(60, lambda: env.runner.quit())
env.runner.greenlet.join()
以下はALBとNLBのレスポンス時間の比較結果です。単位はmsです。
NLBの方がALBよりも低レイテンシであることを確認できます。
| Load Balancer | Request Count | Median Response Time | Average Response Time | Min Response Time | Max Response Time | Requests/s |
|---|---|---|---|---|---|---|
| ALB | 13872 | 4.000000 | 4.177806 | 1.749528 | 46.194923 | 234.685076 |
| NLB | 45697 | 1.046798 | 1.232170 | 1.046798 | 28.522916 | 773.339445 |
参考
Amazon Data Firehoseを用いたApache Icebergテーブルの更新
本記事のコードです。
github.com
Amazon Data Firehoseとは
概要
Amazon Data Firehoseはストリーミングデータの取得・変換・保存を行うマネージドサービスです。
例えば、Eコマースのシステムのデータ基盤を開発する場合、商品のクリックや購入のイベントログを、リアルタイムでデータ基盤に反映する要件が発生します。
このような要件を満たすには、アプリケーションのイベントデータを収集し、データ形式に合わせた変換処理を行い、分析テーブルへの保存をリアルタイムで行うデータパイプラインが必要となります。
アプリケーションのイベントデータのような、継続的にリアルタイムで生成・送信されるデータをストリーミングデータと呼びます。
ストリーミングデータとは - ストリーミングデータの説明 - AWS
様々なストリーミングデータを扱う必要がある場合、リアルタイムで処理を行うデータパイプラインを自前で実装するのは考慮すべき要素が多く開発・運用コストが高いです。
例えば、データ処理が詰まらないためのバッファリング機能や、データ処理エラー時のバックアップ機能、データ保存先が複数ある場合のルーティング機能などを考慮する必要があります。
Amazon Data Firehoseを利用することで、このようなストリーミングデータの取得・変換・保存に関わる一連の機能をAWSが提供してくれます。
Amazon Data Firehose とは何ですか? - Amazon Data Firehose
ストリーミングデータパイプライン – Amazon Data Firehose (Firehose) – AWS
Apache Icebergテーブルへのデータ配信
Amazon Data Firehoseは様々なデータ送信先をサポートしています。
例えば、Amazon S3、Amazon RedshiftのようなAWSサービスから、Datadog、SnowflakeのようなSaaSサービスに対しても、Amazon Data Firehoseからデータを送信することができます。
これらのデータ送信先の中から、Amazon Data Firehoseは Apache Icebergテーブルをサポートしています。
AWSでデータレイクを開発する場合、Apache Iceberg形式で保存するのが候補として上がります。
Apache Iceberg とは? – Iceberg テーブルの説明 – AWS
Apache Iceberg - Apache Iceberg™
AWSでApache Icebergテーブルを管理する場合、Amazon S3 Tablesで管理する方法と、セルフマネージド管理の2つの方法があります。
Amazon Data Firehoseはこれら2つの方法で管理されたApache Icebergテーブルへのデータ転送をサポートしています。
Amazon Data Firehose を使用して Apache Iceberg テーブルにデータを配信する - Amazon Data Firehose
また、Amazon Data Firehoseが取得したデータに応じて、動的にデータ保存先テーブルを変更することができます。
lambda関数によるデータ変換処理
Amazon Data Firehoseはストリーミングデータの取得・変換・保存を行うマネージドサービスです。
Amazon Data Firehoseは、データ変換にあたる処理をユーザーが実装したlambda関数で行うことができます。
Amazon Data Firehose でソースデータを変換する - Amazon Data Firehose
lambda関数のreturnデータ内容に応じて、動的にデータ保存先テーブルを変更できます。
以下のように、metadataセクションを追懐することで保存先テーブルを指定することができます。
 {
    "recordId": "49655962066601463032522589543535113056108699331451682818000000",
    "result": "Ok",
    "data": "1IiwiI6ICJmYWxsIiwgImdgU21IiwiI6ICJmYWxsIiwg==tcHV0ZXIgU2NpZW5jZSIsICJzZW1",
    "metadata":{
    "otfMetadata":{
            "destinationTableName":"Device1234",
            "destinationDatabaseName":"IoTevents",
            "operation":"insert"
        }
    }
  }
Route incoming records to different Iceberg tables - Amazon Data Firehose
構成
全体像
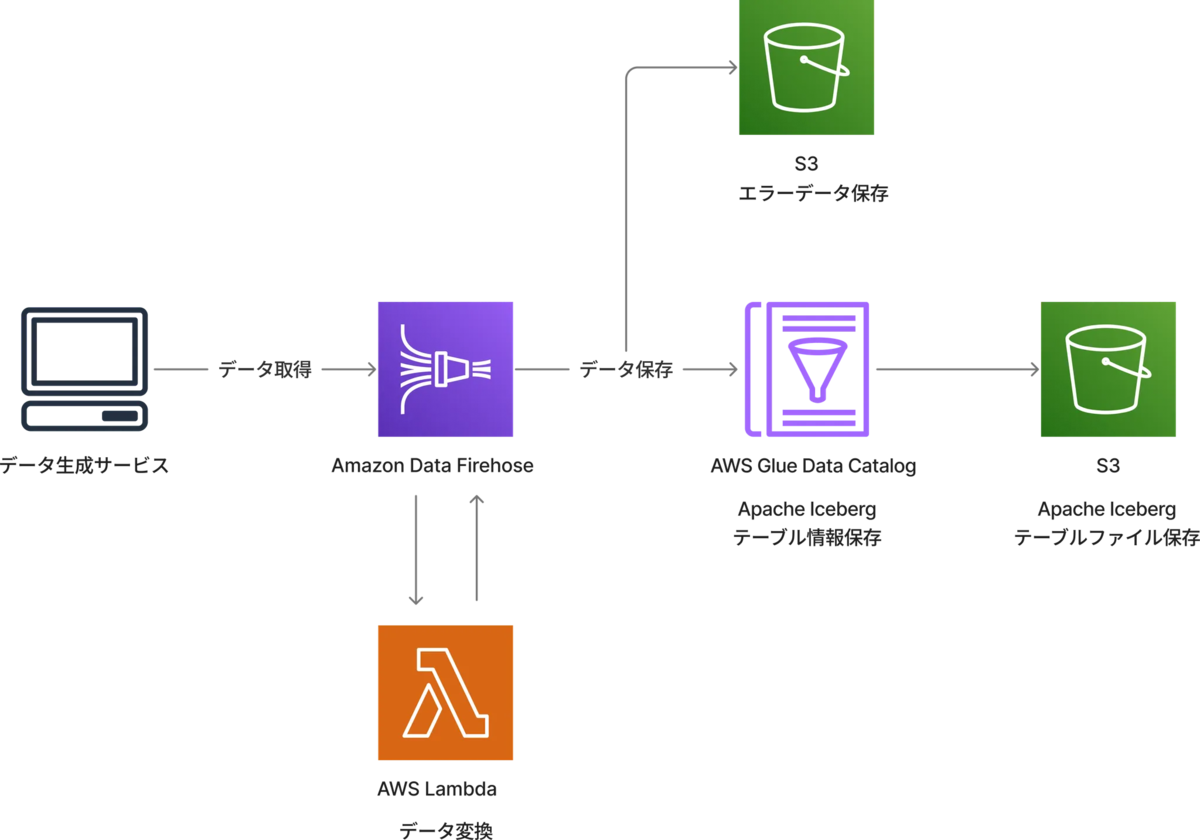
本記事で作成するシステムの構成図です。
以下の処理を行います。
- (データ取得) Amazon Data FirehoseにAmazon SESのイベントデータを送信
- (データ変換) AWS Lambdaで保存先テーブルに合わせてイベントデータをデータ変換
- (データ保存) AWS Glue Data Catalogに保存された Apache Icebergテーブルにレコードを追加
使用データ
本記事ではAWSが提供するメール配信サービスのAmazon SESのイベントデータを使用します。
Amazon SES が Firehose に発行するイベントデータの例 - Amazon Simple Email Service
3つのメール配信イベントのデータを使用します。
- Send: メール送信
- Open: メール開封
- Click: メールクリック
Sendイベントログ例
{
  "eventType": "Send",
  "mail": {
    "timestamp": "2016-10-14T05:02:16.645Z",
    "source": "sender@example.com",
    "sourceArn": "arn:aws:ses:us-east-1:123456789012:identity/sender@example.com",
    "sendingAccountId": "123456789012",
    "messageId": "EXAMPLE7c191be45-e9aedb9a-02f9-4d12-a87d-dd0099a07f8a-000000",
    "destination": [
      "recipient@example.com"
    ],
    "headersTruncated": false,
    "headers": [
      {
        "name": "From",
        "value": "sender@example.com"
      },
      {
        "name": "To",
        "value": "recipient@example.com"
      },
      {
        "name": "Subject",
        "value": "Message sent from Amazon SES"
      },
      {
        "name": "MIME-Version",
        "value": "1.0"
      },
      {
        "name": "Content-Type",
        "value": "multipart/mixed;  boundary=\"----=_Part_0_716996660.1476421336341\""
      },
      {
        "name": "X-SES-MESSAGE-TAGS",
        "value": "myCustomTag1=myCustomTagValue1, myCustomTag2=myCustomTagValue2"
      }
    ],
    "commonHeaders": {
      "from": [
        "sender@example.com"
      ],
      "to": [
        "recipient@example.com"
      ],
      "messageId": "EXAMPLE7c191be45-e9aedb9a-02f9-4d12-a87d-dd0099a07f8a-000000",
      "subject": "Message sent from Amazon SES"
    },
    "tags": {
      "ses:configuration-set": [
        "ConfigSet"
      ],
      "ses:source-ip": [
        "192.0.2.0"
      ],
      "ses:from-domain": [
        "example.com"
      ],
      "ses:caller-identity": [
        "ses_user"
      ],
      "myCustomTag1": [
        "myCustomTagValue1"
      ],
      "myCustomTag2": [
        "myCustomTagValue2"
      ]
    }
  },
  "send": {}
}
それぞれのイベントデータを保存する、send_log, open_log, click_logという名前のApache Icebergテーブルを作成します。
実装
Apache Icebergテーブル作成
本記事では、AWS Glue Data Catalogでテーブル情報を管理して Apache Icebergテーブルを作成します。
以下は、AWS Glue Data Catalogのデータベースと、Apache Icebergテーブルファイルを保存するS3バケットを作成するTerraformコードです。
resource "aws_s3_bucket" "glue_data" {
  bucket_prefix = "glue-data-"
}

resource "aws_glue_catalog_database" "email_event" {
  name         = "email_event"
  location_uri = "s3a://${aws_s3_bucket.glue_data.bucket}/email_event/"
}
Amazon AthenaでApache Iceberg形式でテーブルを作成するSQLを実行します。テーブルファイルの場所を、作成したS3バケットを指定します。
以下は send_logを作成するSQLです。カラムはSESのSendイベントが持つ値を部分的に選択しています。
CREATE TABLE email_event.send_log (
    event_type string,
    message_id string,
    from_address string,
    to_address string,
    timestamp timestamp,
    tags string
)
LOCATION 's3://glue-data-20250924084554937700000001/email_event/send_log/'
TBLPROPERTIES (
    'table_type' = 'ICEBERG',
    'format' = 'parquet',
    'write_compression' = 'gzip'
);
AWSマネジメントコンソールのAWS Glueのサービスページから、send_log, open_log, click_logが作成されていることを確認します。

データ処理用lambda関数作成
Amazon SESのSend, Open, Clickイベントデータを受け取り、Apache Icebergテーブルのレコードに変換するlambda関数の実装です。
公式ドキュメントに記載されている、Amazon Data Firehoseが取得したデータをlambda関数内で処理するサンプルコードを参考にしています。
Route incoming records to different Iceberg tables - Amazon Data Firehose
イベントデータに応じて、送信先テーブルを変更するようにしています。
import base64
import json

def lambda_handler(firehose_records_input, context):
    print(
        "Received records for processing from DeliveryStream: "
        + firehose_records_input["deliveryStreamArn"]
    )

    firehose_records_output = {}
    firehose_records_output["records"] = []

    for firehose_record_input in firehose_records_input["records"]:
        payload_bytes = base64.b64decode(firehose_record_input["data"]).decode("utf-8")
        payload_dict = json.loads(payload_bytes)

        converted_data_dict = {}
        destination_table_name = None

        # 共通イベントデータ
        event_type = payload_dict["eventType"]
        converted_data_dict["event_type"] = event_type
        converted_data_dict["message_id"] = payload_dict["mail"]["messageId"]
        converted_data_dict["tags"] = payload_dict["mail"]["tags"]
        headers = payload_dict["mail"]["headers"]
        for header in headers:
            match header["name"]:
                case "From":
                    converted_data_dict["from_address"] = header["value"]
                case "To":
                    converted_data_dict["to_address"] = header["value"]

        # Sendイベントデータ用処理
        if event_type == "Send":
            converted_data_dict["timestamp"] = payload_dict["mail"]["timestamp"]
            destination_table_name = "send_log"

        # Openイベントデータ用処理
        if event_type == "Open":
            converted_data_dict["ip_address"] = payload_dict["open"]["ipAddress"]
            converted_data_dict["user_agent"] = payload_dict["open"]["userAgent"]
            converted_data_dict["timestamp"] = payload_dict["open"]["timestamp"]
            destination_table_name = "open_log"

        # Clickイベントデータ用処理
        if event_type == "Click":
            converted_data_dict["ip_address"] = payload_dict["click"]["ipAddress"]
            converted_data_dict["link"] = payload_dict["click"]["link"]
            converted_data_dict["link_tags"] = payload_dict["click"]["linkTags"]
            converted_data_dict["user_agent"] = payload_dict["click"]["userAgent"]
            converted_data_dict["timestamp"] = payload_dict["click"]["timestamp"]
            destination_table_name = "click_log"

        converted_data_str = json.dumps(converted_data_dict)
        print("converted_data_str:", converted_data_str)

        # イベントごとに送信先テーブルを指定
        firehose_record_output = {}
        firehose_record_output["data"] = base64.b64encode(
            converted_data_str.encode("utf-8")
        )
        firehose_record_output["recordId"] = firehose_record_input["recordId"]
        firehose_record_output["result"] = "Ok"
        firehose_record_output["metadata"] = {
            "otfMetadata": {
                "destinationDatabaseName": "email_event",
                "destinationTableName": destination_table_name,
                "operation": "insert",
            }
        }
        firehose_records_output["records"].append(firehose_record_output)
        print(firehose_record_output)

    return firehose_records_output
データ変換用lambda関数のIAM Roleを作成するTerraformコードです。
lambda関数のログをCloud Watchに書き込むための権限を付与します。
resource "aws_cloudwatch_log_group" "firehose_processor_lambda" {
  name              = "/aws/lambda/firehose-processor"
  retention_in_days = 365
}

resource "aws_iam_role" "firehose_processor_lambda" {
  name = "firehose_processor_lambda_role"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Action = "sts:AssumeRole"
        Effect = "Allow"
        Principal = {
          Service = "lambda.amazonaws.com"
        }
      }
    ]
  })
}

resource "aws_iam_policy" "firehose_processor_lambda" {
  name        = "firehose_processor_lambda_policy"
  description = "Policy for Firehose processor Lambda role"

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Effect = "Allow"
        Action = [
          "logs:CreateLogGroup",
          "logs:CreateLogStream",
          "logs:PutLogEvents"
        ]
        Resource = [
          "arn:aws:logs:${local.aws_region}:${local.aws_account_id}:log-group:${aws_cloudwatch_log_group.firehose_processor_lambda.name}:*"
        ]
      }
    ]
  })
}
lambda関数用スクリプトをzip化した後、lambda関数を作成するTerraformコードです。
data "archive_file" "firehose_processor_lambda" {
  type        = "zip"
  source_dir  = "../lambda/"
  output_path = "../lambda/firehose_processor.zip"
}

resource "aws_lambda_function" "firehose_processor_lambda" {
  function_name    = "firehose-processor-handler"
  role             = aws_iam_role.firehose_processor_lambda.arn
  filename         = data.archive_file.firehose_processor_lambda.output_path
  handler          = "firehose_processor.lambda_handler"
  runtime          = "python3.12"
  timeout          = 70
  source_code_hash = filebase64sha256(data.archive_file.firehose_processor_lambda.output_path)

  logging_config {
    log_group  = aws_cloudwatch_log_group.firehose_processor_lambda.name
    log_format = "Text"
  }

  depends_on = [
    aws_cloudwatch_log_group.firehose_processor_lambda,
    data.archive_file.firehose_processor_lambda,
  ]
}

resource "aws_lambda_alias" "firehose_processor_lambda_default" {
  name             = "default"
  description      = "Default version."
  function_name    = aws_lambda_function.firehose_processor_lambda.arn
  function_version = "1"
  lifecycle {
    ignore_changes = [function_version]
  }
}
Apache Icebergテーブルへのデータ送信用Amazon Data Firehose作成
Amazon Data Firehoseの IAM Roleを作成するTerraformコードです。
Lambda関数を起動した後、AWS Glue Data Catalogに登録したApache Icebergテーブルに書き込みを行うための権限を付与しています。
resource "aws_cloudwatch_log_group" "firehose_load_iceberg" {
  name              = "/aws/firehose/firehose-load-iceberg"
  retention_in_days = 365
}

resource "aws_cloudwatch_log_stream" "firehose_load_iceberg" {
  name           = "firehose-load-iceberg-log-stream"
  log_group_name = aws_cloudwatch_log_group.firehose_load_iceberg.name
}

resource "aws_iam_role" "firehose_load_iceberg" {
  name = "firehose_load_iceberg_role"

  assume_role_policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Action = "sts:AssumeRole"
        Effect = "Allow"
        Principal = {
          Service = "firehose.amazonaws.com"
        }
      }
    ]
  })
}

resource "aws_iam_policy" "firehose_load_iceberg" {
  name        = "firehose_load_iceberg_policy"
  description = "Policy for Firehose load iceberg role"

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Effect = "Allow"
        Action = [
          "s3:AbortMultipartUpload",
          "s3:GetBucketLocation",
          "s3:GetObject",
          "s3:ListBucket",
          "s3:ListBucketMultipartUploads",
          "s3:PutObject",
          "s3:DeleteObject"
        ]
        Resource = [
          "arn:aws:s3:::*",
          "arn:aws:s3:::*/*"
        ]
      },
      {
        Effect = "Allow"
        Action = [
          "logs:CreateLogGroup",
          "logs:CreateLogStream",
          "logs:PutLogEvents"
        ]
        Resource = [
          "arn:aws:logs:${local.aws_region}:${local.aws_account_id}:log-group:${aws_cloudwatch_log_group.firehose_load_iceberg.name}:*",
          aws_cloudwatch_log_stream.firehose_load_iceberg.arn
        ]
      },
      {
        Effect = "Allow"
        Action = [
          "glue:GetTable",
          "glue:GetDatabase",
          "glue:UpdateTable"
        ]
        Resource = [
          "arn:aws:glue:*:*:catalog",
          "arn:aws:glue:*:*:database/*",
          "arn:aws:glue:*:*:table/*/*"
        ]
      },
      {
        Effect = "Allow"
        Action = [
          "kinesis:DescribeStream",
          "kinesis:GetShardIterator",
          "kinesis:GetRecords",
          "kinesis:ListShards"
        ]
        Resource = [
          "arn:aws:kinesis:*:*:stream/*"
        ]
      },
      {
        Effect = "Allow"
        Action = [
          "lambda:InvokeFunction",
          "lambda:GetFunctionConfiguration"
        ]
        Resource = [
          "arn:aws:lambda:*:*:function:*:*"
        ]
      }
    ]
  })
}

resource "aws_iam_role_policy_attachment" "firehose_load_iceberg" {
  role       = aws_iam_role.firehose_load_iceberg.name
  policy_arn = aws_iam_policy.firehose_load_iceberg.arn
}
エラーデータ保存用のS3バケットと、Amazon Data Firehoseを作成するTerraformコードです。
aws_kinesis_firehose_delivery_stream リソースでAmazon Data Firehoseを作成します。
Apache Icebergテーブルをデータ送信先とするため、iceberg_configurationの設定を行います。また、Amazon Data Firehoseで実行するlambda関数を紐づけています。
resource "aws_s3_bucket" "firehose_load_iceberg" {
  bucket_prefix = "firehose-load-iceberg-"
}

resource "aws_kinesis_firehose_delivery_stream" "firehose_load_iceberg" {
  name        = "firehose-load-iceberg"
  destination = "iceberg"

  iceberg_configuration {
    role_arn           = aws_iam_role.firehose_load_iceberg.arn
    catalog_arn        = "arn:aws:glue:${local.aws_region}:${local.aws_account_id}:catalog"
    buffering_size     = 5
    buffering_interval = 10

    s3_configuration {
      role_arn   = aws_iam_role.firehose_load_iceberg.arn
      bucket_arn = aws_s3_bucket.firehose_load_iceberg.arn
    }

    processing_configuration {
      enabled = "true"

      processors {
        type = "Lambda"

        parameters {
          parameter_name  = "LambdaArn"
          parameter_value = "${aws_lambda_function.firehose_processor_lambda.arn}:${aws_lambda_alias.firehose_processor_lambda_default.name}"
        }
        parameters {
          parameter_name  = "BufferIntervalInSeconds"
          parameter_value = 10
        }
      }
    }

    cloudwatch_logging_options {
      enabled         = true
      log_group_name  = aws_cloudwatch_log_group.firehose_load_iceberg.name
      log_stream_name = aws_cloudwatch_log_stream.firehose_load_iceberg.name
    }
  }
}
動作確認
Amazon Data Firehoseへデータ送信
JSONファイルとして保存したAmazon SESのイベントデータを読み込み、Amazon Data Firehoseにデータを送信するPyhtonスクリプトです。
import json

import boto3

DELIVERY_STREAM_NAME = "firehose-load-iceberg"
JSON_FILE_PATH = "event_data/open.json"

def main():
    with open(JSON_FILE_PATH, "r", encoding="utf-8") as file:
        data = json.load(file)

    firehose_client = boto3.client("firehose", region_name="ap-northeast-1")
    response = firehose_client.put_record(
        DeliveryStreamName=DELIVERY_STREAM_NAME,
        Record={"Data": json.dumps(data, ensure_ascii=False).encode("utf-8")},
    )
    print(f"send data to firehose success: RecordId={response['RecordId']}")

if __name__ == "__main__":
    main()
Amazon Athenaから、Apache Icebergテーブルにデータが追加されていることを確認できます。

エラーデータを保存するS3バケットに、processing-failedが自動的に作成され、以下のようなファイルが保存されます。

エラーデータのファイルには以下のような取得データと、エラーメッセージが含まれます。
{"rawData":"eyJldmVudFR5cGUiOiAiU2VuZCIsICJtYWlsIjogeyJ0aW1lc3RhbXAiOiAiMjAxNi0xMC0xNFQwNTowMjoxNi42NDVaIiwgInNvdXJjZSI6ICJzZW5kZXJAZXhhbXBsZS5jb20iLCAic291cmNlQXJuIjogImFybjphd3M6c2VzOnVzLWVhc3QtMToxMjM0NTY3ODkwMTI6aWRlbnRpdHkvc2VuZGVyQGV4YW1wbGUuY29tIiwgInNlbmRpbmdBY2NvdW50SWQiOiAiMTIzNDU2Nzg5MDEyIiwgIm1lc3NhZ2VJZCI6ICJFWEFNUExFN2MxOTFiZTQ1LWU5YWVkYjlhLTAyZjktNGQxMi1hODdkLWRkMDA5OWEwN2Y4YS0wMDAwMDAiLCAiZGVzdGluYXRpb24iOiBbInJlY2lwaWVudEBleGFtcGxlLmNvbSJdLCAiaGVhZGVyc1RydW5jYXRlZCI6IGZhbHNlLCAiaGVhZGVycyI6IFt7Im5hbWUiOiAiRnJvbSIsICJ2YWx1ZSI6ICJzZW5kZXJAZXhhbXBsZS5jb20ifSwgeyJuYW1lIjogIlRvIiwgInZhbHVlIjogInJlY2lwaWVudEBleGFtcGxlLmNvbSJ9LCB7Im5hbWUiOiAiU3ViamVjdCIsICJ2YWx1ZSI6ICJNZXNzYWdlIHNlbnQgZnJvbSBBbWF6b24gU0VTIn0sIHsibmFtZSI6ICJNSU1FLVZlcnNpb24iLCAidmFsdWUiOiAiMS4wIn0sIHsibmFtZSI6ICJDb250ZW50LVR5cGUiLCAidmFsdWUiOiAibXVsdGlwYXJ0L21peGVkOyAgYm91bmRhcnk9XCItLS0tPV9QYXJ0XzBfNzE2OTk2NjYwLjE0NzY0MjEzMzYzNDFcIiJ9LCB7Im5hbWUiOiAiWC1TRVMtTUVTU0FHRS1UQUdTIiwgInZhbHVlIjogIm15Q3VzdG9tVGFnMT1teUN1c3RvbVRhZ1ZhbHVlMSwgbXlDdXN0b21UYWcyPW15Q3VzdG9tVGFnVmFsdWUyIn1dLCAiY29tbW9uSGVhZGVycyI6IHsiZnJvbSI6IFsic2VuZGVyQGV4YW1wbGUuY29tIl0sICJ0byI6IFsicmVjaXBpZW50QGV4YW1wbGUuY29tIl0sICJtZXNzYWdlSWQiOiAiRVhBTVBMRTdjMTkxYmU0NS1lOWFlZGI5YS0wMmY5LTRkMTItYTg3ZC1kZDAwOTlhMDdmOGEtMDAwMDAwIiwgInN1YmplY3QiOiAiTWVzc2FnZSBzZW50IGZyb20gQW1hem9uIFNFUyJ9LCAidGFncyI6IHsic2VzOmNvbmZpZ3VyYXRpb24tc2V0IjogWyJDb25maWdTZXQiXSwgInNlczpzb3VyY2UtaXAiOiBbIjE5Mi4wLjIuMCJdLCAic2VzOmZyb20tZG9tYWluIjogWyJleGFtcGxlLmNvbSJdLCAic2VzOmNhbGxlci1pZGVudGl0eSI6IFsic2VzX3VzZXIiXSwgIm15Q3VzdG9tVGFnMSI6IFsibXlDdXN0b21UYWdWYWx1ZTEiXSwgIm15Q3VzdG9tVGFnMiI6IFsibXlDdXN0b21UYWdWYWx1ZTIiXX19LCAic2VuZCI6IHt9fQo=","errorCode":"Lambda.InvokeAccessDenied","errorMessage":"Access was denied. Ensure that the access policy allows access to the Lambda function.","attemptsMade":4,"arrivalTimestamp":1758706488335,"attemptEndingTimestamp":1758706512945,"lambdaARN":"arn:aws:lambda:ap-northeast-1:559802578070:function:firehose-processor-handler"}
参考
プライベートサブネット内のlambdaからVPC Endpoints経由でSESを実行する
構成
プライベートサブネット内で起動したlambda関数から、インターネットを経由せずSESを呼び出そうと思います。
本記事では以下の構成でlambda関数からSESを呼び出します。

本文中コード.
github.com
lambdaからSESにアクセスする手段
プライベートサブネット内のlambdaからSESにメールを送信する場合、2通りのインフラ構成が考えれられます。
参考: [アップデート] Amazon SES が SMTP エンドポイントの VPC エンドポイントをサポートしました | DevelopersIO
また、lambdaようなアプリケーションからSESにリクエストを送る場合、SES API か SMTPインターフェイスの2通りの方法があります。
Set up email sending with Amazon SES - Amazon Simple Email Service
インターネット経由でSESにアクセス(SES API / SMTPインターフェイス)
1つ目はNAT GatewayとInternet Gatewayを設置し、インターネット経由でSESを呼び出す方法です。
この方法ではSES APIとSMTPインターフェイス両方の方法でSESにアクセスすることができます。
今回はインターネット接続を行わない方法を検討するので、この構成は採用しません。
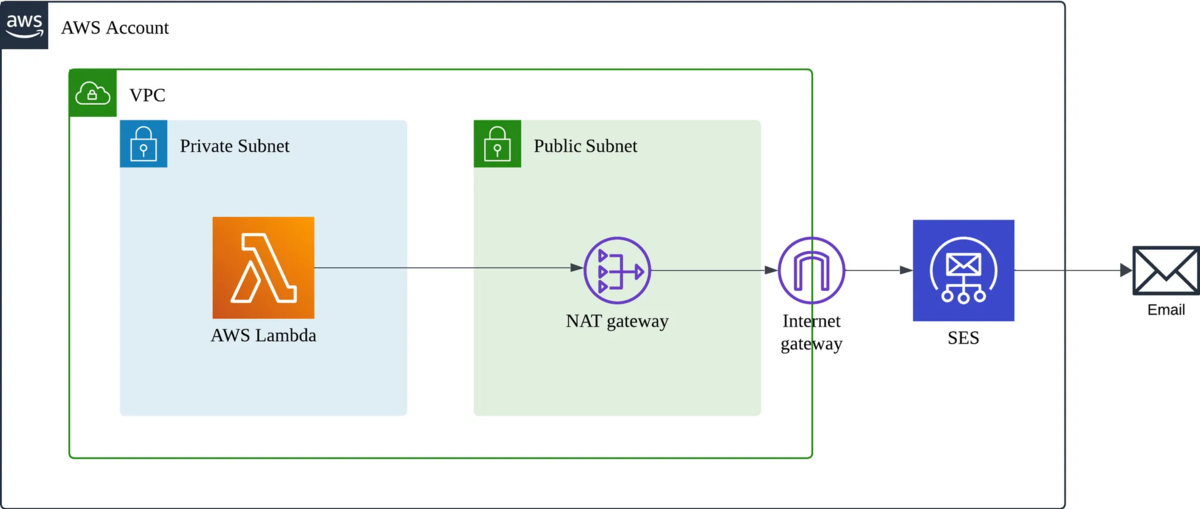
VPC Endpoints経由でSESにアクセス(SMTPインターフェイス)
VPC Endpoints経由でプライベートサブネットのクライアントから直接SESへアクセスできます。
注意点として、VPC Endpointsを利用したSESへのアクセスはSMTPインターフェイスのみサポートされています。
AWSサポートに問い合わせてくれている方がいます。
VPC内のLambdaからはSES向けのVPCエンドポイントを使用してもBoto3ではメールを送信できない #Python - Qiita
インターネットを経由しないため、今回はこの構成を採用します。

VPC Endpoints経由でSTMPインターフェイスでメール送信する
Terraform
AWSリソースを作成するTerraformを用意しました
$ git clone https://github.com/nsakki55/lambda-ses-vpc-endpoints
$ cd lambda-ses-vpc-endpoints
AWSアカウントとSESで送るメールの値を環境変数に設定します。
$ export AWS_ACCOUNT_ID=<aws_account_id>
$ export AWS_REGION=<aws_region>
$ export DOMAIN=<domain>
$ export FROM_ADDRESS=<from_address>
$ export TO_ADDRESS=<to_address>
今回のインフラ構成をterraformで作成します。
$ cd terraform
$ terraform init
$ terraform apply -var="aws_account_id=$AWS_ACCOUNT_ID" -var="aws_region=$AWS_REGION" -var="domain=$DOMAIN"
$ cd ..
lambda関数のDocker imageをビルドしECRにデプロイします
$ make build
$ make push
SMTP認証情報の作成
SMTPインターフェイスでSESにアクセスする場合、SMTP認証情報を取得する必要があります。
AWSコンソールからSMTP認証ユーザーを作成する手順が公式ドキュメントで紹介されています。
Obtaining Amazon SES SMTP credentials - Amazon Simple Email Service.
IAMユーザーを作成し、SMTP認証に必要な2つの値をSecretManagerに保存しています。
- アクセスキー
- シークレットアクセスキーから作成したSMTPパスワード
シークレットアクセスキーとSMTPパスワードは異なる値ですので注意してください。
SMTP認証用のIAMユーザーに、SESでメールを送信するためのポリシーをアタッチしています。
resource "aws_iam_user" "smtp_user" {
  name = "smtp-user"
}

resource "aws_iam_access_key" "smtp_user_key" {
  user = aws_iam_user.smtp_user.name
}

resource "aws_secretsmanager_secret" "smtp_credential" {
  name = "smtp-credential"
}

resource "aws_secretsmanager_secret_version" "smtp_credentials" {
 secret_id = aws_secretsmanager_secret.smtp_credential.id
 secret_string = jsonencode({
   username = aws_iam_access_key.smtp_user_key.id
   password = aws_iam_access_key.smtp_user_key.ses_smtp_password_v4
 })
}

resource "aws_iam_user_policy" "smtp_user_policy" {
  name = "smtp-user-policy"
  user = aws_iam_user.smtp_user.name

  policy = jsonencode({
    Version = "2012-10-17"
    Statement = [
      {
        Effect = "Allow"
        Action = [
          "ses:SendEmail",
          "ses:SendRawEmail"
        ]
        Resource = "*"
      }
    ]
  })
}
SMTPインターフェイス用VPC Endpointsの作成
SMTPインターフェイスでSESにアクセスするための、VPC Endpoints、セキュリティグループを作成します。
com.amazonaws.ap-northeast-1.email-smtp がSES用のVPC Endpointsサービスです。
SMTPプロトコルで通信するために、587ポートのインバウンドルールをVPC Endpointsのセキュリティグループに設定します。
resource "aws_vpc" "main" {
  cidr_block           = "10.1.0.0/16"
  enable_dns_support   = true
  enable_dns_hostnames = true
}

resource "aws_subnet" "private" {
  vpc_id            = aws_vpc.main.id
  availability_zone = "${var.aws_region}a"
  cidr_block        = "10.1.10.0/24"
}

locals {
  aws_services = [
    "com.amazonaws.${var.aws_region}.email-smtp",
    "com.amazonaws.${var.aws_region}.secretsmanager",
  ]
}

resource "aws_vpc_endpoint" "aws_services_interface_type" {
  for_each            = toset(local.aws_services)
  vpc_id              = aws_vpc.main.id
  service_name        = each.value
  vpc_endpoint_type   = "Interface"
  private_dns_enabled = true
  subnet_ids          = [aws_subnet.private.id]
  security_group_ids  = [aws_security_group.aws_services_interface_endpoints.id]
  tags = {
    Name = "Invoke SES via SMTP"
  }
}

resource "aws_security_group" "aws_services_interface_endpoints" {
  name   = "aws-services-interface-endpoints-sg"
  vpc_id = aws_vpc.main.id
}

resource "aws_security_group" "invoke_ses" {
  name   = "invoke-ses-sg"
  vpc_id = aws_vpc.main.id
}

resource "aws_vpc_security_group_egress_rule" "invoke_ses" {
  security_group_id = aws_security_group.invoke_ses.id
  cidr_ipv4         = "0.0.0.0/0"
  ip_protocol       = "-1"
  from_port         = -1
  to_port           = -1
}

resource "aws_vpc_security_group_ingress_rule" "allows_access_to_interface_endpoints" {
  security_group_id            = aws_security_group.aws_services_interface_endpoints.id
  referenced_security_group_id = aws_security_group.invoke_ses.id
  from_port                    = 443
  to_port                      = 443
  ip_protocol                  = "tcp"
}

resource "aws_vpc_security_group_ingress_rule" "allows_smtp_access_to_interface_endpoints" {
  security_group_id            = aws_security_group.aws_services_interface_endpoints.id
  referenced_security_group_id = aws_security_group.invoke_ses.id
  from_port                    = 587
  to_port                      = 587
  ip_protocol                  = "tcp"
}
SMTPインターフェイスでSESにアクセスするlambda関数の作成
SecretManagerからSMTP認証情報を取得し、SMTPインターフェイスでSESにアクセスする処理を記述したlambda関数です。
SMTPサーバーにはSESのVPC EndpointsのプライベートDNS名 email-smtp.ap-northeast-1.amazonaws.com を指定します。
import os
import json
import boto3
import smtplib
from email.mime.text import MIMEText
from email.mime.multipart import MIMEMultipart

def get_smtp_credential() -> tuple[str, str]:
    session = boto3.session.Session()
    client = session.client(service_name="secretsmanager", region_name="ap-northeast-1")
    response = client.get_secret_value(SecretId="smtp-credential")
    secret = json.loads(response["SecretString"])

    smtp_username = secret["username"]
    smtp_password = secret["password"]
    return smtp_username, smtp_password

def handler(event, context) -> None:
    # メールの作成
    msg = MIMEMultipart()
    msg["From"] = os.environ['FROM_ADDRESS']
    msg["To"] = os.environ['TO_ADDRESS']
    msg["Subject"] = "test title"
    email_body = "This is test email via smtp."
    msg.attach(MIMEText(email_body, "plain"))

    # SMTPサーバーにメール送信
    smtp_server = "email-smtp.ap-northeast-1.amazonaws.com"
    smtp_port = 587
    smtp_username, smtp_password = get_smtp_credential()
    with smtplib.SMTP(smtp_server, smtp_port) as server:
        server.starttls()
        server.login(smtp_username, smtp_password)
        server.send_message(msg)

    return {"statusCode": 200, "body": json.dumps("Email sent successfully")}
動作確認
lambda関数をテスト実行すると、実行が成功します。

設定した送信元メールアドレスから、メールが届いてることを確認できます。

参考
AWS Glueでicebergテーブルのスキーマを動的に変更する
本記事は datatech-jp Advent Calendar 2024 の13日目の記事です。
はじめに
Glue Catalogに登録したiceberg tableにAWS GlueJobでデータの書き込みを行うケースは多いかと思います。
通常、Glue Catalogのスキーマに登録されていないカラムを持つデータをGlue Jobで書き込もうとするとエラーとなります。
そのため、新しいカラムを持つデータを書き込む前に alter table add columns をAthenaなどで実行し、iceberg tableのスキーマ変更を行う必要があります。
ALTER TABLE ADD COLUMNS - Amazon Athena
Glue Jobの処理で新しくカラムを追加した場合や、元データにカラムが追加された場合に毎回上記の対応を行うのは運用コストが高く、操作ミスの危険もあります。
本記事では、扱うデータのカラムに応じて動的にiceberg tableのカラムを追加する方法をまとめます。
Glue Job実行のためのAWSリソース準備
AWS GlueJobを実行するための、S3 Bucket・IAM Role・Glue Database・Glue Jobを作成するTerraformを作成しました。
$ cd terraform
$ terraform init
$ terraform apply
AWS Glue jobでiceberg tableに対する操作を有効化する場合、Glue JobのSpark Configurationを適切に設定する必要があります。
AWS Glue での Iceberg フレームワークの使用 - AWS Glue.
terraformのコードからglue jobのリソースを作成する部分を抜粋すると、以下のようになります。
resource "aws_glue_job" "update_iceberg_table_schema" {
  name              = "update_iceberg_table_schema"
  role_arn          = aws_iam_role.glue_job_role.arn
  glue_version      = "4.0"
  worker_type       = "G.1X"
  number_of_workers = 2
  max_retries       = 0
  execution_property {
    max_concurrent_runs = 10
  }

  command {
    script_location = "s3://${aws_s3_bucket.glue_job.bucket}/scripts/update_iceberg_table_schema.py"
  }

  default_arguments = {
    "--enable-glue-datacatalog"          = "true"
    "--TempDir"                          = "s3://${aws_s3_bucket.glue_job.bucket}/temporary/"
    "--spark-event-logs-path"            = "s3://${aws_s3_bucket.glue_job.bucket}/sparkHistoryLogs/"
    "--enable-job-insights"              = "false"
    "--enable-continuous-cloudwatch-log" = "true"
    "--datalake-formats"                 = "iceberg"
    # conf to enable iceberg format. ref: https://docs.aws.amazon.com/ja_jp/glue/latest/dg/aws-glue-programming-etl-format-iceberg.html
    "--conf" = "spark.sql.extensions=org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions --conf spark.sql.catalog.glue_catalog=org.apache.iceberg.spark.SparkCatalog --conf spark.sql.catalog.glue_catalog.catalog-impl=org.apache.iceberg.aws.glue.GlueCatalog --conf spark.sql.catalog.glue_catalog.io-impl=org.apache.iceberg.aws.s3.S3FileIO --conf spark.sql.catalog.glue_catalog.warehouse=file:///tmp/spark-warehouse"
  }
Glue Jobで取り込んでicebergテーブルに書き込むためのサンプルデータを2つ用意しました。
https://github.com/nsakki55/code-for-blogpost/tree/main/glue_job_iceberg_schema_change/data
test_data.csv
| col1 | col2 |
|---|---|
| aaa | 1 |
| bbb | 2 |
| ccc | 3 |
test_data_new_column.csv
| col2 | col1 | col3 |
|---|---|---|
| 444 | ddd | XXX |
| 555 | eee | YYY |
| 666 | fff | ZZZ |
2つのテストデータの差は以下です
- col1, col2のカラムの順序が異なる
- col3という新しいカラムが追加されている
今回はS3 Bucketに2つのサンプルデータを配置して、Glue Jobで読み込む元データとします。
アップロード先のS3 Bucket名をterraform applyで生成したS3 Bucket名に変更して下さい。
$ aws s3 cp ./data/test_data.csv s3://schema-change-data-20241208085330834400000002/input/
$ aws s3 cp ./data/test_data_new_column.csv s3://schema-change-data-20241208085330834400000002/input/
icebergテーブルにデータを追加するGlueJobの作成
S3からcsvデータを読み込んだ後、以下の処理を行うGlue Jobを作成しました。
- テーブルが存在しない場合
- テーブルを作成
- テーブルが存在する場合
- テーブルにデータを追加
import sys
from typing import Dict

from awsglue.context import GlueContext
from awsglue.job import Job
from awsglue.utils import getResolvedOptions
from awsglue.dynamicframe import DynamicFrame
from pyspark.context import SparkContext

S3_BUCKET = "schema-change-data-20241208085330834400000002"
TABLE_NAME = "test_table"
DATABASE_NAME = "test_database"
CATALOG_NAME = "glue_catalog"

def get_dynamic_frame_from_s3(glue_context: GlueContext, source_s3_path: str) -> DynamicFrame:
    print(f"Start get dynamic frame from S3. {source_s3_path=}")
    dyf = glue_context.create_dynamic_frame.from_options(
        format_options={
            "withHeader": True,
            "separator": ",",
        },
        connection_type="s3",
        format="csv",
        connection_options={
            "paths": [source_s3_path],
        },
    )
    print(f"Finished get dynamic frame from S3. {dyf.count()=}")
    return dyf

def check_table_in_database(glue_context: GlueContext, database_name: str, table_name: str) -> bool:
    print(f"Start check table in database. {database_name=}, {table_name=}")
    tables = glue_context.spark_session.catalog.listTables(database_name)
    is_exist = table_name in [table.name for table in tables]
    print(f"Finished check table in database. {is_exist=}")
    return is_exist

def main(args: Dict[str, str]) -> None:
    sc = SparkContext()
    glue_context = GlueContext(sc)
    job = Job(glue_context)
    job.init(args["JOB_NAME"], args)
    print(f"Start update iceberg table schema. {args=}")

    dyf = get_dynamic_frame_from_s3(
        glue_context=glue_context,
        source_s3_path=f"s3://{S3_BUCKET}/input/{args['file_name']}",
    )
    df = dyf.toDF()
    df.printSchema()

    is_exist = check_table_in_database(glue_context=glue_context, database_name=DATABASE_NAME, table_name=TABLE_NAME)

    table_path = f"{CATALOG_NAME}.{DATABASE_NAME}.{TABLE_NAME}"
    if is_exist:
        df.writeTo(table_path).append()
    else:
        df.writeTo(table_path).tableProperty("format-version", "2").tableProperty("location", f"s3://{S3_BUCKET}/output").create()

    print(f"Finished update iceberg table schema. {args=}")
    job.commit()

if __name__ == "__main__":

    args = getResolvedOptions(sys.argv, ["JOB_NAME", "file_name"])
    main(args)
Glue Jobの実行スクリプトをS3にアップロードします。S3 Bucketをterraform applyで作成したS3 Bucket名に変更して下さい。
$ aws s3 cp ./src/update_iceberg_table_schema.py s3://glue-job-20241208085330834300000001/scripts/
1つ目のサンプルデータであるtest_data.csvを読み込むGlue Jobを実行します。
$ aws glue start-job-run \
    --job-name update_iceberg_table_schema \
    --arguments '{"--file_name": "test_data.csv"}'
Glue Catalogのスキーマを見ると、col1, col2が追加されています

icebergテーブルのスキーマを変更する
icebergでは動的にスキーマ変化できる、mergeSchemaというオプションが提供されています。
Writes - Apache Iceberg™.
mergeSchemaオプションを使用する場合、以下の挙動となります。
新しいカラムがデータソースに存在するが、対象のテーブルにカラムが存在しない場合
→ 新しいカラムが対象のテーブルに追加される。既存のレコードの新しいカラムにはnullが設定される。
データソースにカラムが存在しないが、対象のテーブルにはカラムが存在する場合
→ 新しいレコードを追加・レコードを更新すると、対象のカラムにnullが設定される。
mergeSchemaオプションを使用するには、対象のテーブルのプロパティ設定に 'write.spark.accept-any-schema'='true' を追加する必要があります。
ALTER TABLE test_database.test_table SET TBLPROPERTIES (
  'write.spark.accept-any-schema'='true'
)
上記のプロパティ追加のクエリをAthena経由で実行すると、サポートされていないプロパティエラーがでます。
Unsupported table property key: write.spark.accept-any-schema
Athenaでは変更可能なicebergテーブルのプロパティに制限があります。
Create Iceberg tables - Amazon Athena
そのため、上記のプロパティ変更をAthena経由では行えません。
AWSが出してるicebergテーブルに関する記事で、'write.spark.accept-any-schema'='true' のプロパティ設定をspark経由で実行してるのを確認できます。
Modernize your legacy databases with AWS data lakes, Part 2: Build a data lake using AWS DMS data on Apache Iceberg | AWS Big Data Blog
本記事ではこの方法に習い、spark経由で必要なプロパティ設定を行います。
既存テーブルへのデータ追加の実装を以下のように変更しました。
sql = f"ALTER TABLE {table_path} SET TBLPROPERTIES ('write.spark.accept-any-schema' = 'true')"
glue_context.spark_session.sql(sql)
df.writeTo(table_path).option("mergeSchema","true").append()
新しいカラムを持つcsvデータを読み込むGlueJobを実行します
$ aws glue start-job-run \
    --job-name update_iceberg_table_schema \
    --arguments '{"--file_name": "test_data_new_column.csv"}'
しかし、上記の設定のGlueJobは失敗します。
原因はcol1, col2のカラムの順番がテーブルスキーマと元データで異なるためです。
2024-12-09 01:21:18,419 ERROR [main] glue.ProcessLauncher (Logging.scala:logError(77)): Error from Python:Traceback (most recent call last):
  File "/tmp/update_iceberg_table_schema.py", line 74, in <module>
    main(args)
  File "/tmp/update_iceberg_table_schema.py", line 63, in main
    df.writeTo(table_path).option("mergeSchema","true").append()
  File "/opt/amazon/spark/python/lib/pyspark.zip/pyspark/sql/readwriter.py", line 1460, in append
    self._jwriter.append()
  File "/opt/amazon/spark/python/lib/py4j-0.10.9.5-src.zip/py4j/java_gateway.py", line 1321, in __call__
    return_value = get_return_value(
  File "/opt/amazon/spark/python/lib/pyspark.zip/pyspark/sql/utils.py", line 196, in deco
    raise converted from None
pyspark.sql.utils.IllegalArgumentException: Cannot write incompatible dataset to table with schema:
table {
  1: col1: optional string
  2: col2: optional string
  3: col3: optional string
}
Provided schema:
table {
  2: col2: optional string
  1: col1: optional string
  3: col3: optional string
}
Problems:
* col2 is out of order, before col1
icebergのspark optionには check-ordering という設定があります。
これは入力スキーマとテーブルスキーマが同じかチェックする設定で、デフォルトではTrueとなります。
icebergのGitHubレポジトリのmergeSchemaに関するissueで議論されているように、スキーマ変更するためにcheck-ordering をFalseにする必要があります。
Adding new columns (mergeSchema) · Issue #8908 · apache/iceberg · GitHub
GlueJobのリソースを作成するterraform設定に、以下のconfigを追加します。
--conf spark.sql.iceberg.check-ordering=false
GlueJobの変更を反映します
$ terraform apply
新しいカラムを持つcsvデータを読み込むGlue Jobを再び実行します。今度はJobが成功します。
$ aws glue start-job-run \
    --job-name update_iceberg_table_schema \
    --arguments '{"--file_name": "test_data_new_column.csv"}'
Glue Catalogのスキーマを確認すると、スキーマが変更されcol3が追加されているのを確認できます。

test_tableの中身を確認してみると、既存のレコードには新しく追加されたcol3のカラムにnullが設定されています。

GlueJobから動的にiceberg tableのスキーマを変更できることができるようになりました。
